
大规模整数规划的求解技术
拉格朗日松弛
基础概念
- 松弛问题定义:
和 如果满足——(1) (2) ,则称后一个问题是前面那个问题的一个松弛。简单讲一个问题的松弛就是可行域不更小、目标函数值在原问题可行域上不更差,最常见的构造出这样一对松弛问题的方式就是线性松弛、拉格朗日松弛 - 对偶问题定义:
和 ,如果 都有 ,则称这两个问题为一对弱对偶问题,如果进一步存在 则称这两个问题为一对强对偶,根据对偶的定义,一个最小化问题的参数为 拉格朗日松弛对参数 求max的问题一定是原问题的一个弱对偶,这个弱对偶称为拉格朗日对偶 - 原始边界和对偶边界的定义:原始边界通过找原问题的可行解得到,对偶边界通过求解松弛问题得到。线性松弛得到的对偶边界是唯一的,原问题的参数为
的拉格朗日松弛能提供的对偶边界也是唯一的,若进一步把 当中变量,则原问题的拉格朗日松弛能提供的对偶边界不唯一,要找到原问题拉格朗日松弛能提供的最好对偶边界,必须求解原问题的拉格朗日对偶问题
求解拉格朗日对偶问题的方法
考虑原问题
他对应的参数为
选择松弛约束的原则
- 能够提供更紧的对偶边界
- 松弛问题更容易求解
进而可以写出
拉格朗日松弛的乘子符号问题:等式约束的乘子是自由的。非等式约束对应乘子的符号取决于你写的形式,只要保证违反约束时目标函数能受到惩罚就行
在一些特殊的情况下,比如我们可以把拉格朗日对偶中的
对于给定的
- 更新方向:函数
的次梯度 - 步长选择的收敛性保证,设步长序列
,其中 ,当 足够大的时候可以保证次梯度算法的收敛性 - polyak步长
,其中分子是估计最大值和当前目标函数值的偏差,分母是当前点次梯度平方和,当高估最大值时可以保证收敛,但是低估无法保证收敛
基于拉格朗日松弛的启发式算法
如果我们在求解拉格朗日对偶的同时能不断得到更好的原始边界,也就是不断提升下界,降低上界,这样的思路就是基于拉格朗日松弛的启发式算法。一种最简单的思路就是根据拉格朗日松弛的解(不一定是原问题的可行解)通过某种启发式规则得到原问题的可行解。
一种基于拉格朗日松弛的启发式from typing import Callable
from math import inf
from numpy import array,where,ndarray
from numpy.linalg import norm

class SubgradientLgHeuristics:
    def __init__(self,inital_mutiplier:ndarray,gezero:ndarray,guess_lb:float,
        max_iter:int=100,verbose:bool=False)->None:
        """
        Params:
            inital_mutiplier:初始化拉格朗日乘子
            gezero:逻辑数组,取1表示对应位置的乘子要求大于等于0,取0则表示没有限制
            guess_ls:原问题最大拉格朗日对偶下界的一个估计值,用于_polyak方法计算步长
            max_iter:最大迭代次数
            verbose:是否打印求解过程
        Returns:
            None
        """
        self.inital_mutiplier = inital_mutiplier
        self.gezero = gezero
        self.guess_lb = guess_lb
        self.max_iter = max_iter
        self.verbose = verbose

    def solve(self,lgsolver:Callable,rule:Callable,subgrad_func:Callable,theta:float,epsilon:float):
        """
        Args:
            lgsolver:拉格朗日松弛问题的求解器,给定参数u求解拉格朗日乘子u对应的拉格朗日松弛问题,得到原问题的一个下界
            rule:启发式规则获取原问题的可行解,以及原问题的一个上界
            subgrad_func:输入拉格朗日松弛的解,获得拉格朗日对偶函数的次梯度
            theta:步长控制参数
            epsilon:允许容差
        Returns:
            lb: 拉格朗日松弛能够提供的最大下界
            ub:原问题的上界
            feasible:原问题上界对应的可行解
            u:最优拉格朗日乘子
            history_lb: 历史下界
            history_ub: 历史上界
        """
        lb,ub = -inf,inf # 原问题的上下界
        best_feasible = None # 原问题最好的可行解
        u = self.inital_mutiplier # 拉格朗日乘子
        not_better = 0 # 检测下界有多久没有提升了
        history_lb,history_ub = [],[] # 上下界历史
        for iteration in range(self.max_iter):
            # 求解拉格朗日松弛、启发式规则得到原问题的可行解
            x,lgobj = lgsolver(u)
            print(x,u)
            feaible,obj = rule(x)
            last_lb = lb
            # 更新上下界和原问题最优可行解
            lb = lgobj if lgobj > lb else lb
            ub = obj if obj < ub else ub
            best_feasible = feaible if obj < ub else best_feasible
            history_lb.append(lb)
            history_ub.append(ub)
            # 更新拉格朗日乘子,让拉格朗日乘子不断靠近最优乘子
            gamma = subgrad_func(x) # 根据拉格朗日松弛的解计算次梯度
            step = self._polyak(lgobj,self.guess_lb,gamma,theta)
            u = where(self.gezero&(u+step*gamma<0),1e-5,u+step*gamma) # 所有有大于0要求的乘子取自身和0当中较大者
            if norm(step*gamma,ord=2) < epsilon:
                return lb,ub,feaible,u,history_lb,history_ub  # 返回原问题的下界、上界、最优可行解、最优拉格朗日乘子
            # 检查下界是否很长时间未更新
            if lb >= last_lb:
                not_better += 1
            if not_better % (self.max_iter//4) == 0:
                theta = theta/2
        else:
            return lb,ub,feaible,u,history_lb,history_ub # 返回原问题的下界、上界、最优可行解、最优拉格朗日乘子

    def _polyak(self,lgobj,guess_lb,gamma,theta):
        step = theta*(lgobj-guess_lb)/norm(gamma,ord=2)**2
        return step
列生成
列生成技术怎么用
用一般化的经典问题——切割下料问题来说明列生成算法的使用方法。首先,给出如下记号:
集合
:表示需求的集合, ,其中 是需求的种类数量。 :表示可行切割方案的集合, ,其中 是可行切割方案的数量。 :表示可用木材的集合, ,其中 是可用木材的种类数量。
参数
:表示需求 的所需数量。 :表示需求 对应的材料长度。 :表示方案 中需求 的数量。 :表示木材 的长度。 :如果方案 使用的是木材 则取1,否则取0。这种参数叫做indicator parameter。 :表示木材 的单价。 :方案 的成本, 。 :方案 使用的木材的长度, 。
决策变量
:表示方案 的使用次数。
切割下料问题就是要在满足客户需求的情况下最求最低的成本,它的数学模型如下,记作
这个模型求解的难点在与——在大多数情况下基本不可能提前枚举出所有的可行方案,也就是说我们得不到集合
然后通过定价子问题,记作
关于reduced cost的计算
-
reduced cost =
-
由于线性规划问题具有强对偶性,设
是对偶值构成的列向量,则有 ,所以
注意到切割下料问题的定价子问题需要决策的变量就是
由于参数
上述过程用流程图可以表示为:求解限制主问题
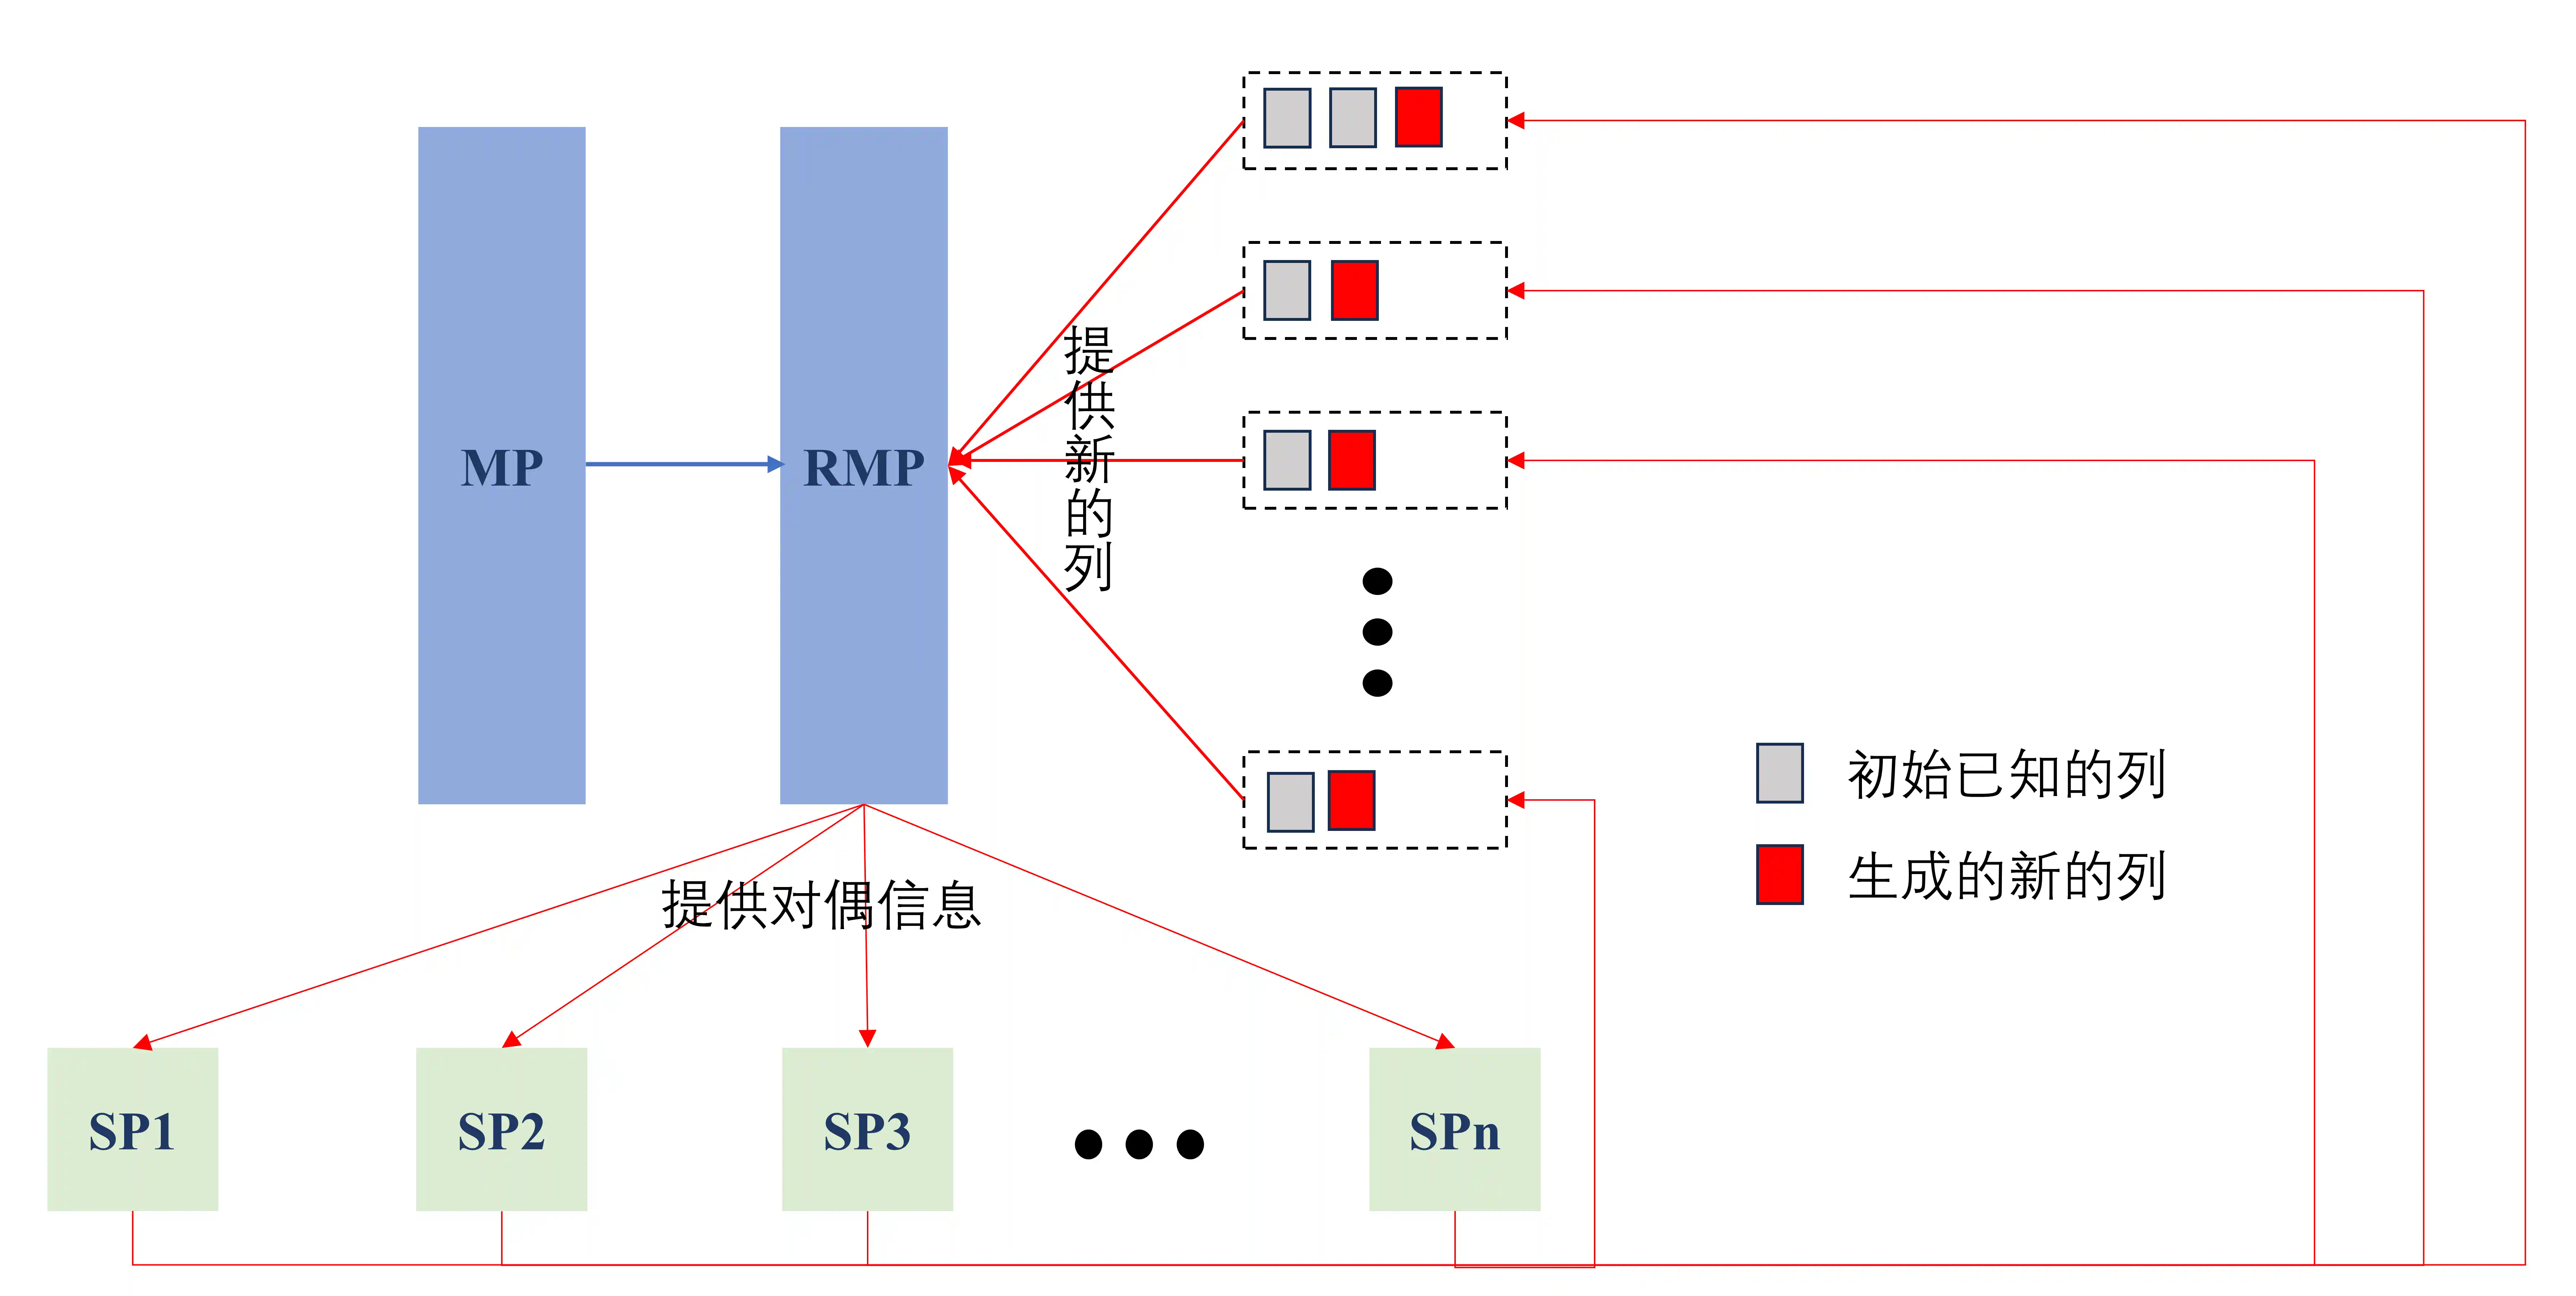
关于列生成算法的一些新思考
- 和DW分解的关系:DW分解是将块对角结构线性规划模型进行变形的技巧,分解的对象是简单约束集,使用多面体表示定理将简单约束集表示为极点凸组合加上极方向的非负组合。用DW分解转换后的模型非常 适合使用列生成算法进行求解,定价子问题就是取找简单约束集的极点
- 什么样模型可以用列生成算法求解:任何线性规划模型都可以用列生成算法求解,但是只有在处理约束简单,变量多的线性规划问题的时候使用列生成技术才有优势,所以经常涉及到引入方案的概念对模型做重构。
-
对于整数规划问题:将整数约束加入到最后一个
当中,然后重新求解,如果模型建立的好,这个模型的Gap和原整数规划模型的Gap应该是可以接受的。另一种处理思路是将列生成嵌套到分支定界算法中,也就是使用分支定价算法进行求解
求解器层面的核心操作
根据列生成算法流程涉及了用于快速搭建列生成算法求解问题的框架cgframework,这个框架包含两个基础类:
- CGModel:用于搭建列生成模型,运行求解算法
- ToolBox:用于管理列生成算法所需的算子——updateRMP、updateSubPs和sovleSubPs方法分别用于更新主问题、定价子问题以及求解定价子问题
cgframework框架#!/usr/bin/env python
# -*- coding: utf-8 -*-
# @Date    : 2025-10-07 19:15:04
# @Author  : syuansheng (Dalian Maritime University)

from functools import partial # 固定某些参数来创建一个新的函数,之后可以使用更少的函数调用它
from gurobipy import *

class CGModel(object):
    def __init__(self,rmp,subps,toolbox):
        """管理限制主问题、定价子问题以及他们的更新工具
        Args:
            rmp: 限制主问题对应的模型,定义了变量,目标函数、优化方向,约束条件
            subps: 定价子问题对应模型的列表,定义了变量,优化方向,约束条件
            toolbox: 已经注册过的ToolBox类型,包含updateRMP、updateSubPs和sovleSubPs方法分别用于更新主问题、
                     定价子问题以及求解定价子问题
        """
        self.rmp = rmp
        self.subps = subps
        self.toolbox = toolbox
        # 由于惰性更新机制的存在,用toolbox中注册的函数的时候可能会提前访问模型,
        # 又比如下面self.number_of_var = len(rmp.getVars())提前访问模型中的变量对象,
        # 为了保证不出错,这里调用write、update实现完成更新操作
        # optimize,write,update
        self.rmp.write("Initial_RMPModel_{}.lp".format(self.rmp.ModelName))
        for subp in self.subps:
            subp.update()
        self.num_var = len(rmp.getVars()) # 记录每次更新限制主问题之前,限制主问题中变量的个数,可以用来给新增变量命名

    def runModel(self):
        while True:
            self.rmp.optimize()
            y = self.rmp.getAttr('Pi',self.rmp.getConstrs()) # 获取每个约束对应的对偶值,这里返回的是一个列表
            self.toolbox.updateSubPs(self,y) # 使用对偶信息更新定价子问题
            solutionlst,objvallst,colobjs = self.toolbox.solveSubPs(self) # 求解定价子问题,返回各个子问题的最优解(列)、最优值,以及(可能)的新列对应的价值系数
            newcols,newobjs = [],[] # 收集可以使得rmp变好的列对象,以及这些列对应于rmp目标函数前的系数
            for i,obj in enumerate(objvallst):
                if self.rmp.ModelSense == GRB.MINIMIZE:
                    # 那么定价子问题目标函数小于0可以让限制主问题变好
                    if obj < 0:
                        newcols.append(Column(solutionlst[i],self.rmp.getConstrs()))
                        newobjs.append(colobjs[i])
                else:
                    if obj > 0:
                        newcols.append(Column(solutionlst[i],self.rmp.getConstrs()))
                        newobjs.append(colobjs[i])
            if newcols:
                self.toolbox.updateRMP(self,newcols,newobjs) # 将新的列添加到限制主问题当中去
                self.num_var += len(newcols) # 变量个数多了len(newcols)个
            else:
                break
        # 将整数约束放回限制主问题重新求解
        self.rmp.setAttr('VType',self.rmp.getVars(),GRB.INTEGER)
        self.rmp.write("Final_RMPModel_{}.lp".format(self.rmp.ModelName))
        # 之前可能设置了不在控制台输出限制主问题的求解过程,但最后一次打开
        self.rmp.Params.LogToConsole = 1
        self.rmp.optimize()
        # 把求解结果写入文件
        self.rmp.write("Solution_{}.sol".format(self.rmp.ModelName))
        print("Solution of {} model has been successfully stored into file {}"\
            .format(self.rmp.ModelName,"Solution_{}.sol".format(self.rmp.ModelName)))

class ToolBox(object):
    """
    有哪些参数,以及模型具体怎么更新得让用户自行指定,这里沿用
    的是开源进化算法框架DEAP的ToolBox类的设计思路
    """
    def register(self, alias, function, *args, **kargs):
        """将自定义函数加入工具箱
        Args:
            alias: 自定义函数的别名,必须设置为updateRMP或updateSubPs或sovleSubps
            function: 自定义的函数
            *args: 位置参数,用于固定function中部分参数
            **kargs: 关键字参数,用于固定function中部分参数
        Details: 针对functions的定义,必须遵守一下规范——
            (1) updateRMP(cgmodel,newcols,newobjs):用来更新RMP的函数的第一个参数必须用来接受CGModel对象,第二个参数必须是要添加的新列,第三个参数必须是要添加的新列在限制主问题的目标函数中的系数
            (2) updateSubPs(cgmodel,y):用来更新定价子问题的函数的第一个参数必须用来接受CGModel对象,第二个参数必须用于接收限制主问题各行约束的对偶值构成的列表
            (3) solveSubPs(cgmodel):用来求解定价子问题的函数第一个参数必须用来接受CGModel对象
        """
        pfunc = partial(function, *args, **kargs)
        pfunc.__name__ = alias # 设置函数的__name__属性
        pfunc.__doc__ = function.__doc__ # 设置函数的__doc__属性
        if hasattr(function, "__dict__") and not isinstance(function, type):
            pfunc.__dict__.update(function.__dict__.copy()) # 保持原函数的所有元数据和自定义属性,使得包装后的函数看起来和行为更像原函数。
        setattr(self, alias, pfunc)   # 这个register的实现逻辑就是新增属性,并将函数绑定到上面

    def unregister(self, alias):
        delattr(self, alias) # 就是删除属性

__all__ = ['CGModel','ToolBox']
经典问题求解
切割下料问题
问题描述
一家加工厂目前有三种类型的木材,三种木材的长度和单价如下表所示:
| ID | Length | Price |
|---|---|---|
| 0 | 9 | 5 |
| 0 | 14 | 9 |
| 0 | 16 | 10 |
现在市场上有三种木料的需求,各种需求木料的长度和需求量如下表所示:
| ID | Length | Demand |
|---|---|---|
| 0 | 4 | 30 |
| 0 | 5 | 20 |
| 0 | 7 | 40 |
请你给出木材加工方案,在满足需求的条件下最求最小的成本。
符号说明
:表示需求的集合, ,其中 是需求的种类数量。 :表示可行切割方案的集合, ,其中 是可行切割方案的数量。 :表示可用木材的集合, ,其中 是可用木材的种类数量。 :表示需求 的所需数量。 :表示需求 对应的材料长度。 :表示方案 中需求 的数量。 :表示木材 的长度。 :如果方案 使用的是木材 则取1,否则取0。 :表示木材 的单价。 :方案 的成本, 。 :方案 使用的木材的长度, 。 :表示方案 的使用次数。
写出限制主问题和定价子问题
限制主问题(
定价子问题(
根据初始方案写出限制主问题和定价子问题
在具体的参数条件下,我们可以枚举出一些具体的方案
| s | ||||
|---|---|---|---|---|
| 1 | (1,0,0) | (1,0,0) | 5 | 9 |
| 2 | (0,1,0) | (1,0,0) | 5 | 9 |
| 3 | (0,0,1) | (1,0,0) | 5 | 9 |
方案编码是什么?
方案编码是方案的具体表现形式,它包含决策所需的所有信息。例如,在切割下料问题中,每个方案编码都应该包含以下两个方面的信息:
- 使用什么长度的木材?
- 这个木材应该怎么切割?
从而对于这个问题引入方案概念时引入的所有新集合、新参数、新变量所包含信息的并集就必须包含上述两方面,在这里就是每一组
进一步,应该怎么得到方案编码的具体值呢?注意到
切割下料问题的定价子问题比较简单,定价子问题的解就是
补充一点:方案的引入是唯一的吗?并不是,还是以切割下料问题为例,在第一解我们引入方案是新增加的集合和参数是
:可行方案的集合 : 木材k使用切割方案 进行切割得到的木料中包含需求 的数量 :方案 的成本
进而也可以将限制主问题写成:
它的
把已知的方案带入
分析一下
可以得到第一个定价子问题
第二个定价子问题
第三个定价子问题
写求解程序
#!/usr/bin/env python
# -*- coding: utf-8 -*-
# @Date    : 2025-10-08 19:41:49
# @Author  : syuansheng (Dalian Maritime University)

import sys
sys.path.append('..')
from cgframework import *
from gurobipy import *

# 定义限制主问题
rmpmodel = Model('cspRMP')
rmpmodel.Params.LogToConsole = 0
rmpmodel.Params.LogFile = 'cspRMPLog.txt'
x = rmpmodel.addVars(3,lb=0,vtype=GRB.CONTINUOUS,name='x')
rmpmodel.setObjective(
    quicksum(x[j]*5 for j in range(3)),
    sense = GRB.MINIMIZE
    )
rmpmodel.addConstr(x[0]        >= 30)
rmpmodel.addConstr(    x[1]    >= 20)
rmpmodel.addConstr(        x[2]>= 40)

# 定义定价子问题
subpmodel1 = Model('sp1')
subpmodel2 = Model('sp2')
subpmodel3 = Model('sp3')
subpmodels = [subpmodel1,subpmodel2,subpmodel3]
N = [4,5,7]
L = [9,14,16]
for i in range(3):
    subpmodels[i].Params.LogToConsole = 0
    subpmodels[i].Params.LogFile = 'cspSUBPLog{}.txt'.format(i)
    a = subpmodels[i].addVars(3,lb=0,vtype=GRB.INTEGER,name='a')
    subpmodels[i].ModelSense = GRB.MINIMIZE
    subpmodels[i].addConstr(quicksum(N[j]*a[j] for j in range(3))<=L[i])

def updateRMP(cgmodel,newcols,newobjs):
    """
    RMP的更新方法
    """
    for i,(newcol,newobj) in enumerate(zip(newcols,newobjs)):
        cgmodel.rmp.addVar(lb=0,obj=newobj,vtype=GRB.CONTINUOUS,name='x['+str(cgmodel.num_var+i)+']',column=newcol)

def updateSubPs(cgmodel,y):
    """
    SubPModels的更新方法
    """
    c = [5,9,10]
    for i in range(3):
        a = cgmodel.subps[i].getVars()
        cgmodel.subps[i].setObjective(
            c[i]-quicksum(y[j]*a[j] for j in range(3)),
            sense = GRB.MINIMIZE
            )

def solveSubPs(cgmodel):
    """
    SubPModels的求解方法
    """
    solutionlst,objvallst,colobjs = [],[],[5,9,10]
    for i in range(3):
        cgmodel.subps[i].optimize()
        solution = [var.X for var in cgmodel.subps[i].getVars()]
        objval = cgmodel.subps[i].ObjVal
        solutionlst.append(solution)
        objvallst.append(objval)
    return solutionlst,objvallst,colobjs

toolbox = ToolBox()
toolbox.register('updateRMP',updateRMP)
toolbox.register('updateSubPs',updateSubPs)
toolbox.register('solveSubPs',solveSubPs)
cgmodel = CGModel(rmpmodel,subpmodels,toolbox)
cgmodel.runModel()
并行机排程问题
这个例子比前面的切割下料问题更难,为了完整走一遍使用列生成技术求解一般问题的流程,我们先建立出它的一般化模型,再引入方案的概念对它进行重构,转化成变量特别多,约束特别简单的问题,设计 合适的定价子问题用于获取方案编码。
应用列生成算法求解问题的范式
- 如果原模型没有使用方案的概念,则引入方案的概念,分析每个方案所需要包含哪些信息,得到方案编码。使用集合划分、集合覆盖或包裹约束对模型进行重构,得到限制主问题和定价子问题,并把定价子问题拆到能拆的最小粒度,得到若干定价子问题——这里需要回答一个非常非常重要的问题,为什么引入方案概念对模型做重构之后就可以使用列生成算法求解了:我目前的理解是,因为方案非常多,重构的模型一般约束会变的比原来更简单,而变量数要比原来多得多,而这种特点的模型正适合使用列生成算法进行求解。实际上,列生成算法可以处理任何线性规划问题,但是对于变量个数很少的线性规划模型 完全就没有去做列生成的必要…
- 给出初始方案,在初始方案下写出限制主问题和定价子问题
- 编写求解程序
问题描述
一家工厂有若干台机器和等待加工的工件,每个工件都只需要在一个机器上加工,且加工过程中不能中断,每个机器在任意时刻只能加工一个工件。已知工件在每个机器上的加工时间, 以及最早可以什么时候加工。要求在完成所有工件加工的情况下最小化工件完工时间之和。
符号说明
:表示机器的集合, ,其中 表示机器的数量 :表示工件的集合, ,其中 表示工件的数量 :表示在机器 上可以在工件 之后加工的工件的集合 :表示在机器 上可以在工件 之前加工的工件的集合 :表示工件 在机器 上的加工时间 :决策变量,如果 都在机器 上加工,且工件 在工件 之后加工则 否则取0。记 表示 在 上第一个被加工, 表示在 在机器 上最后一个被加工 :辅助变量,表示工件 的完工时间
关于参数
-
:就是对于所有的 ,满足——工件 在机器 上的最早开始时间大于工件 在机器 上最早完工时间的工件的集合 -
:就是对于所有的 ,满足——工件 在机器 上的最早完工时间小于工件 在机器 上最早开工时间的工件的集合
模型建立
目标函数是最小化工件完工时间之和:
约束条件1:每个工件都要在某个机器上按某个次序被加工:
约束条件2和3:在每个机器上工件,每个工件的加工时间都不能与其他工件发生冲突:
约束条件4:辅助变量
变量约束:
引入方案,重构模型
首先来分析一下,如何引入方案。原模型的决策包含的信息是——每台机器处理哪些工件,处理的顺序是什么。所以咱们的方案编码也必须得包含这些信息,一种可行的编码是:
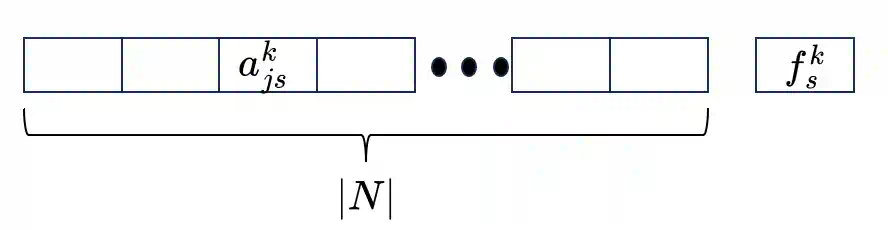
对于机器
引入新的集合:
:表示可行方案的集合, ,其中 表示可行方案的数量 :表示在机器 上可行方案的集合
引入新的参数:
:机器 使用的方案 是否包含工件 ,如果包含则取1否则取0,Indicator paramiter :机器 使用的方案 的最大完工时间
引入新的决策变量:
:机器 是否使用方案 ,如果使用则取1,否则取0
分析一下每个机器只会选择一个方案,也就是说对于固定的
虽然模型变量,但是问题还是哪个问题,约束要达到的效果还是每个工件都要被加工,只不过把加工哪些工件、顺序是什么的考量放到子问题中去了,记主问题
写出限制主问题和定价子问题
为了方便,不引入新的记号,假设下面的模型就是上一模型的限制主问题
记第一组约束和第二组约束对应的对偶变量分别为
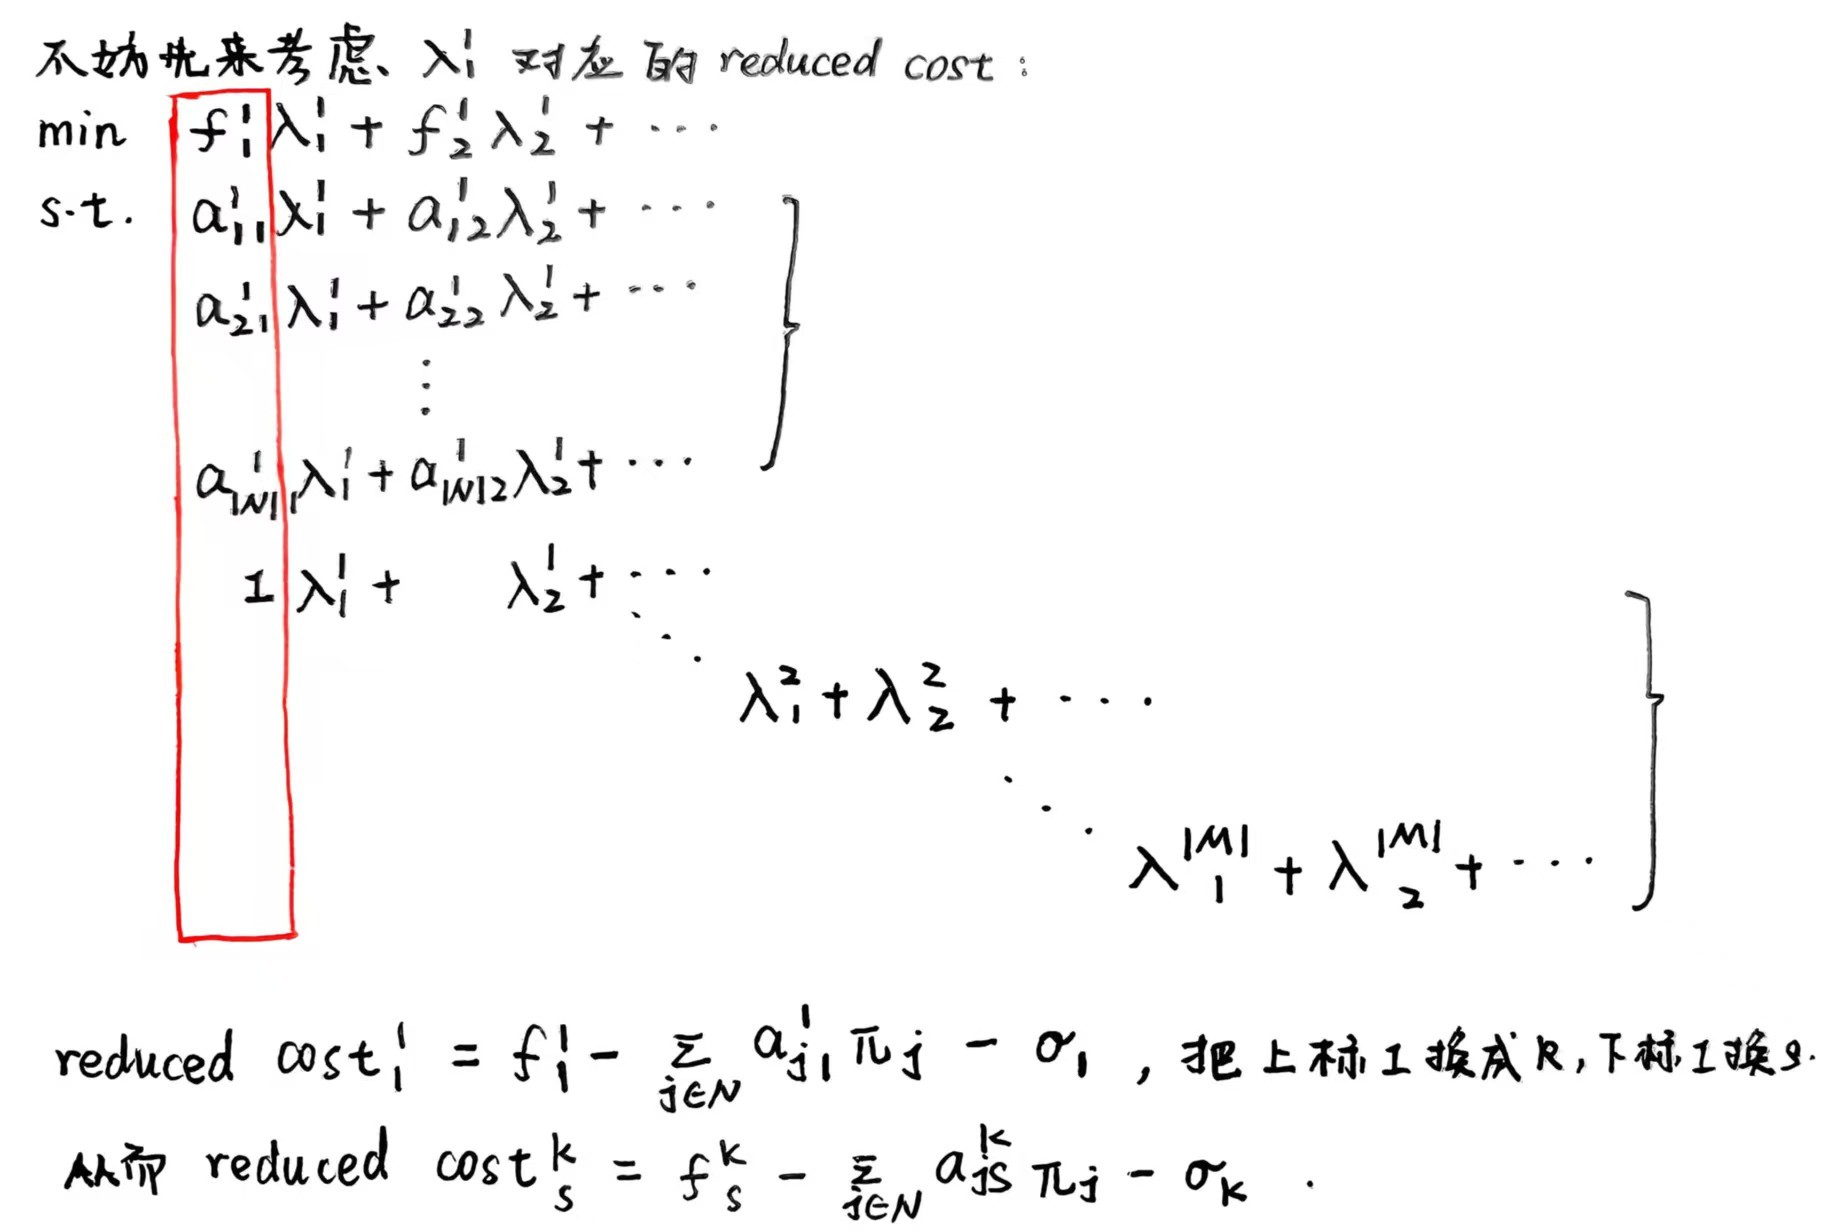
得到变量
分析一下,
好了,目标函数现在转换为决策变量
最后两步——具体问题写出限制主问题和定价子问题,然后编程求解相对简单,这里就不赘述了。
论文复现实战篇
参考论文
- Integrated planning of berth allocation and vessel sequencing in a seaport with one-way navigation channel
- Short-term berth planning and ship scheduling for a busy seaport with channel restrictions
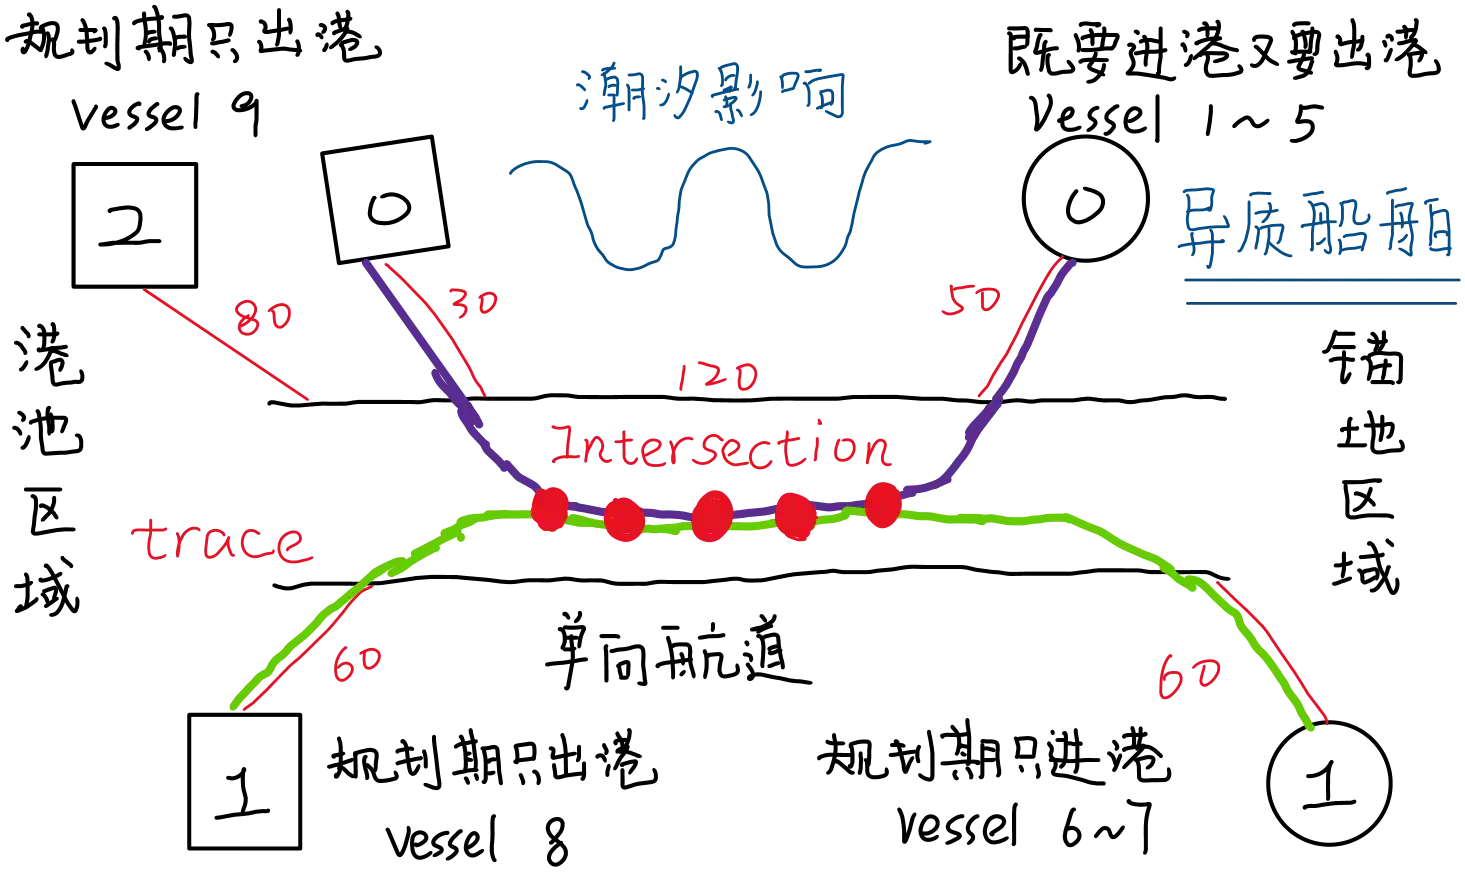
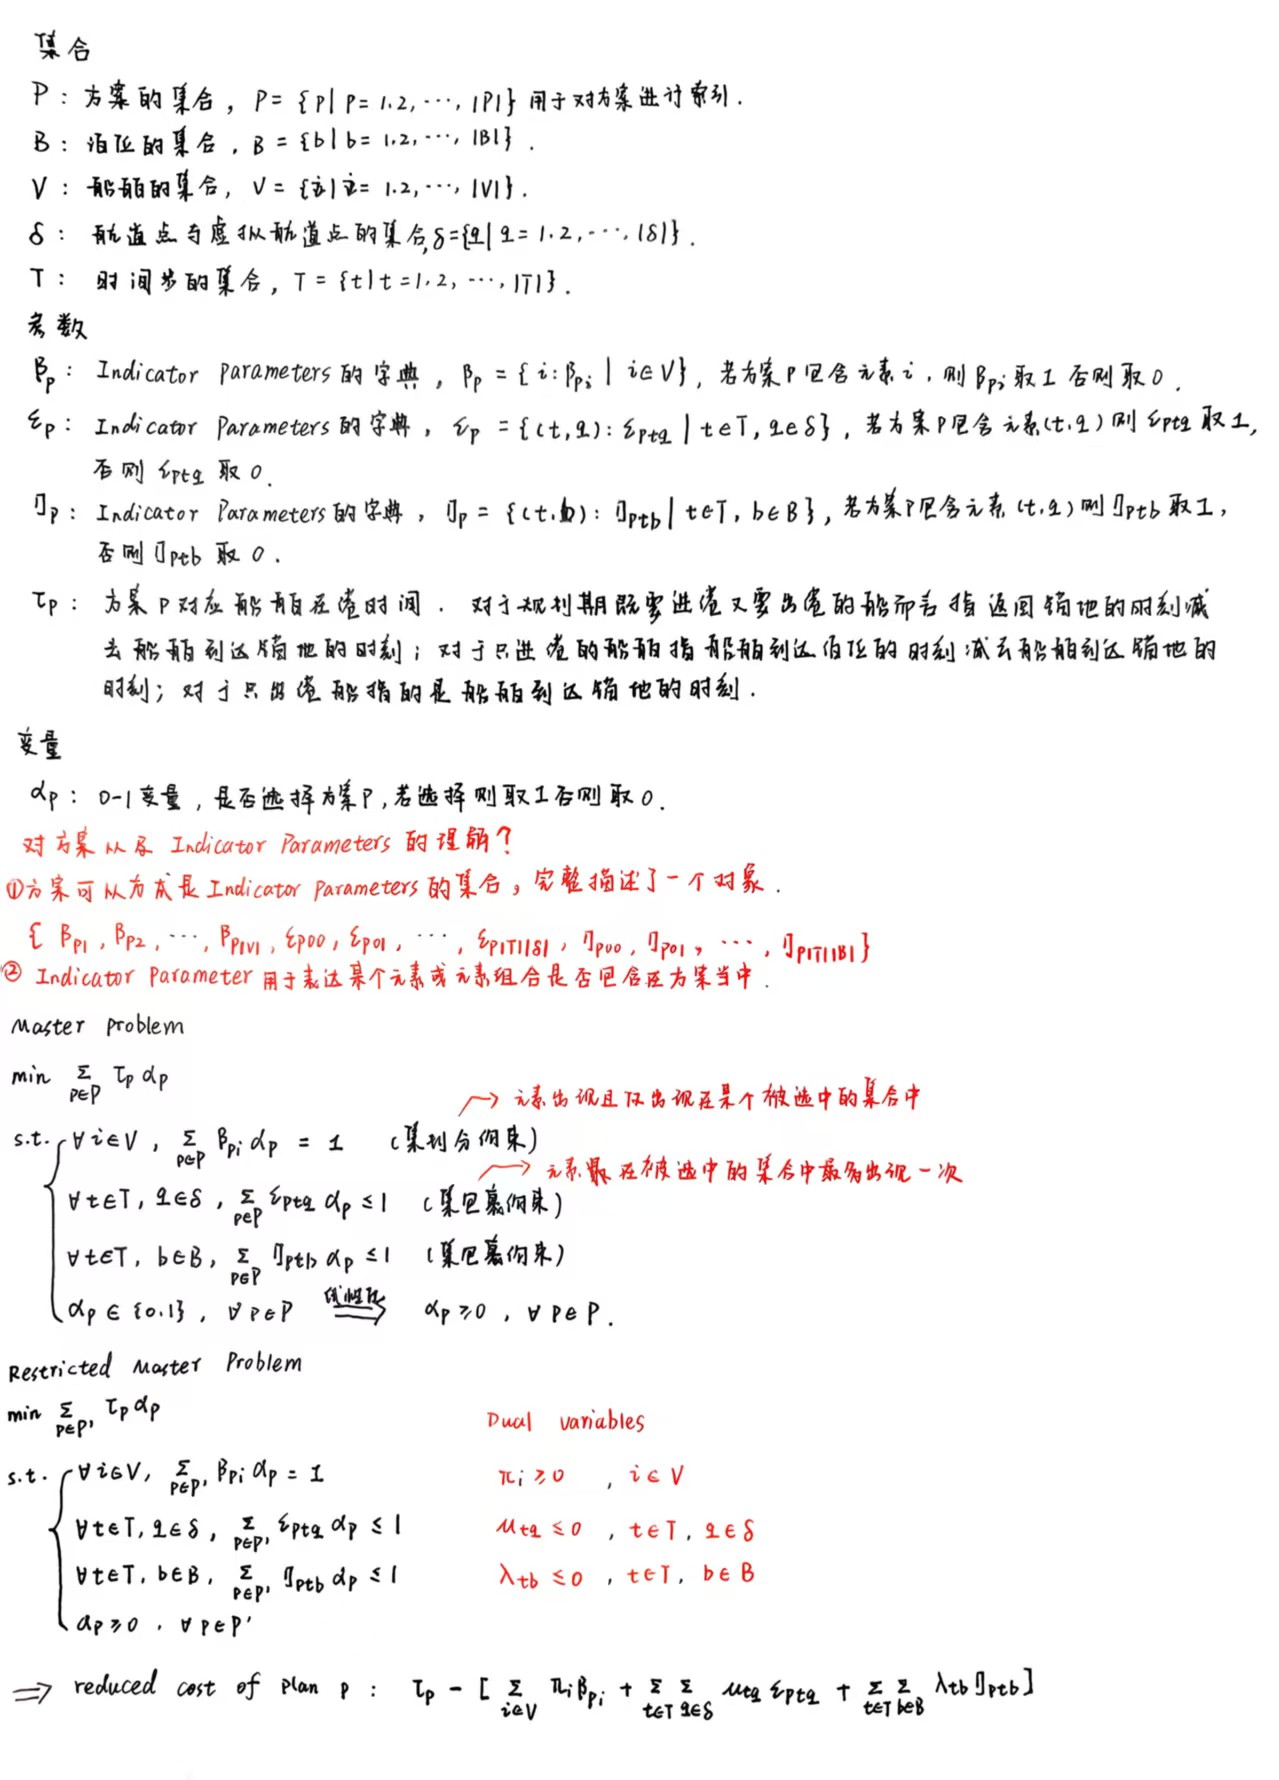
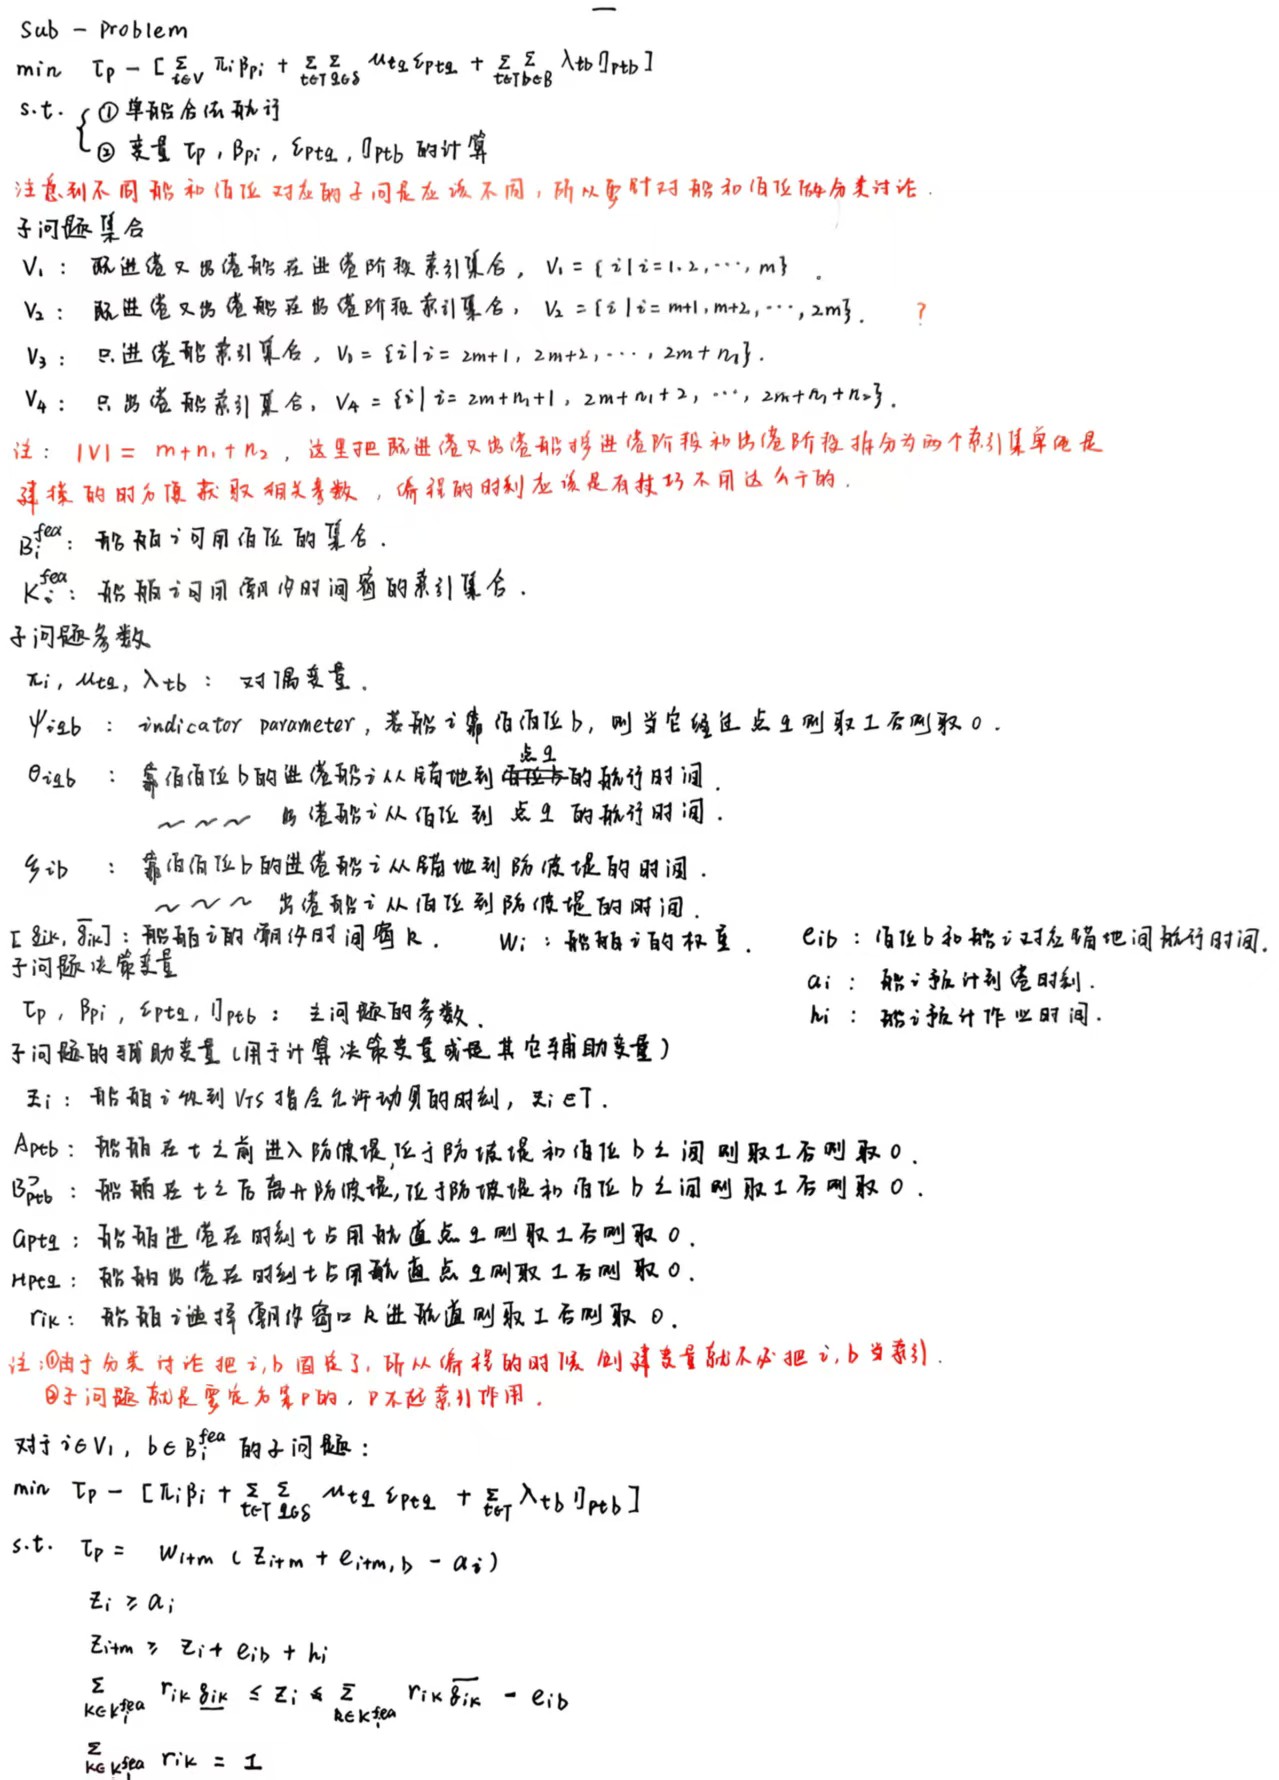
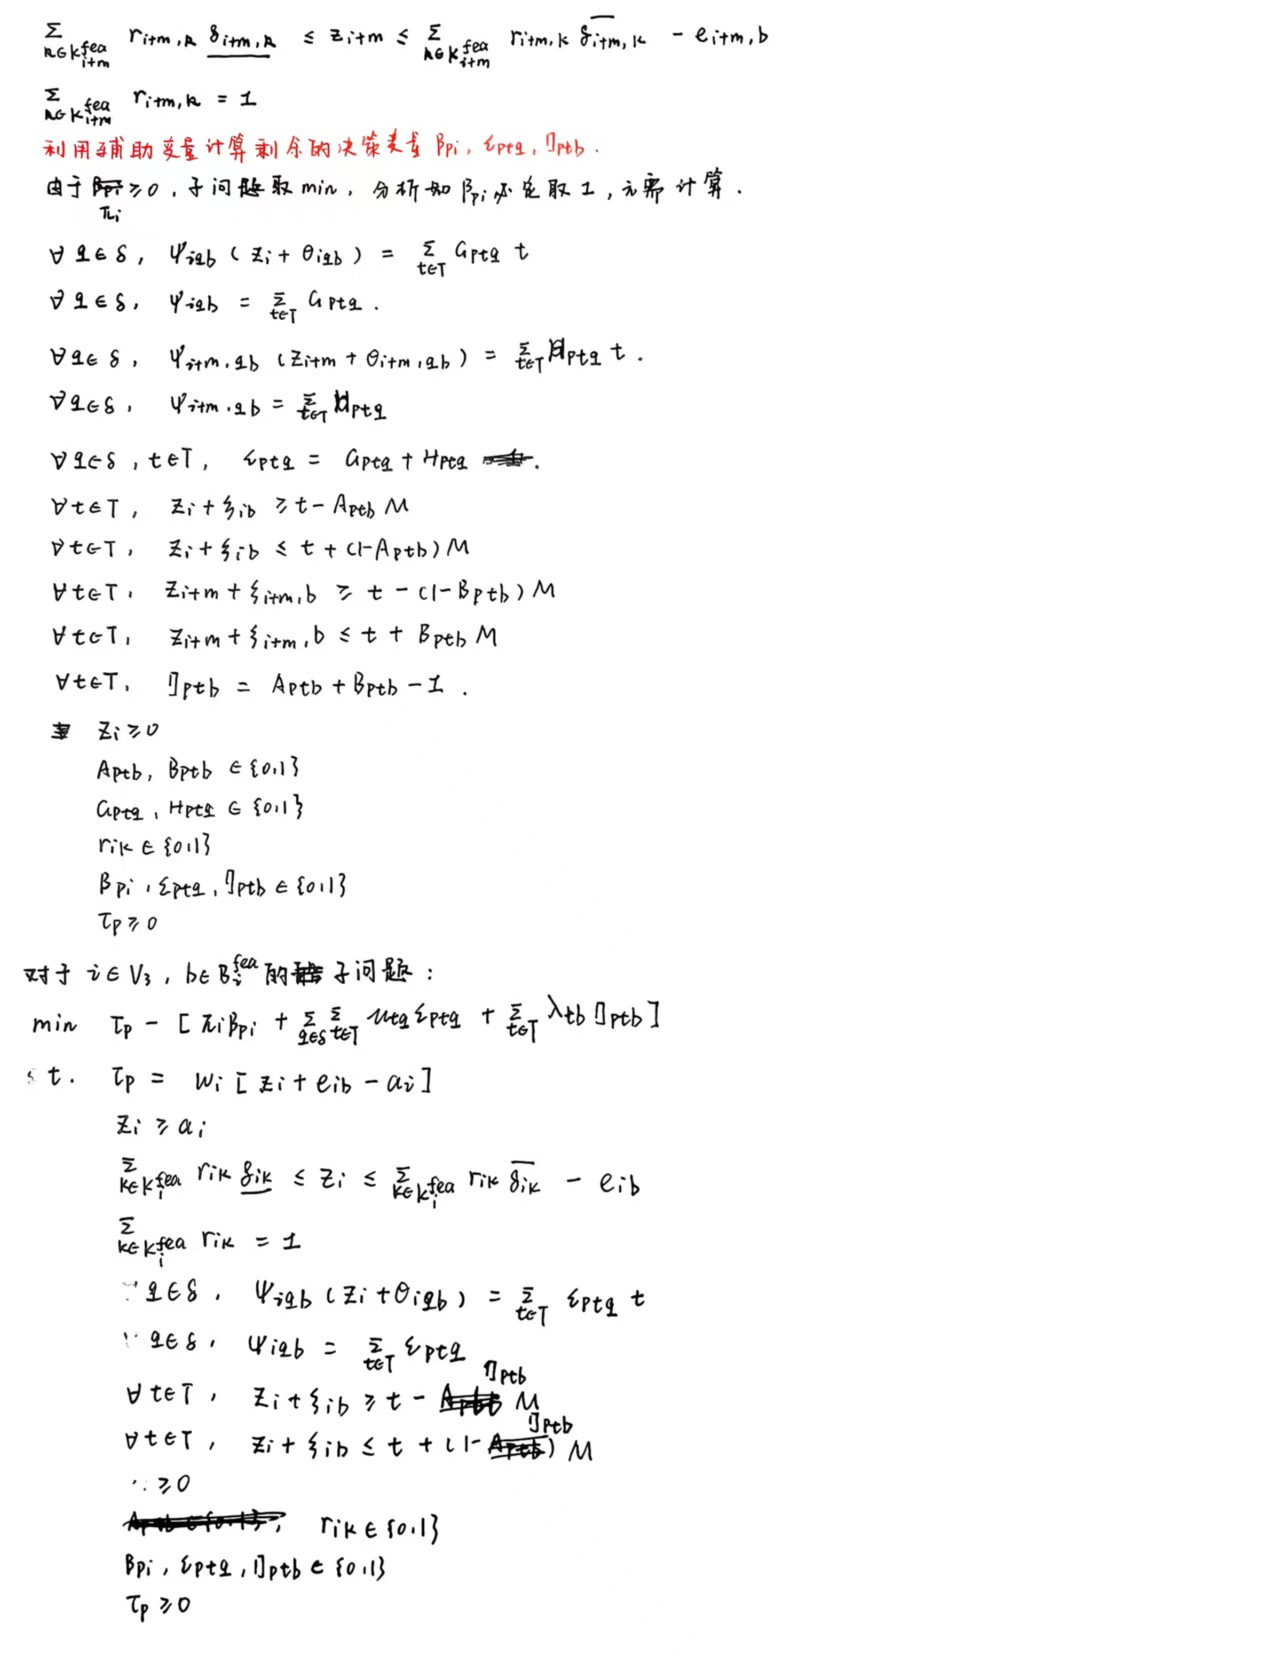
这个问题的研究场景如上图所示,用通俗的话讲就是:我们首先划定一个时间区间,在这个时间区间内整个港口会存在至少三种作业类型的船舶——第一种是在这个时间区间内陆续到港想要进行装卸作业的船舶,这样的船在到港后首先会在港外水域的锚地内等待,直到船舶交管中心发出许可,才能通过航道前往港内水域执行装卸作业。针对第一类船舶,我们还可以根据他们的作业时长做进一步的划分,比如说某条船的作业时间非常长,在我们划定的时间区间内它都没办法完成作业,这样的船我们就称它为在规划期内只进港的船。除了上述两种类型的船,还会存在第三种类型的船舶,这种船舶在我们划定的时间区间的开始阶段就已经位于港内水域的某个泊位执行装卸作业了,针对这样的船,称它们为在规划期只出港的船,一旦他们完成剩余的装卸作业并且得到船舶交管中心的许可,就可以进入航道驶离港口。扯回开头,航道调度与泊位分配集成问题要解决的就是针对这样一些异质船舶,它们可能在航速、潮汐和泊位方面存在差异,我们如何在保证航行安全、满足船舶差异化需求、追求尽可能短的船舶在港时间的同时协调好它们各自进出航道的时刻以及分配的泊位。
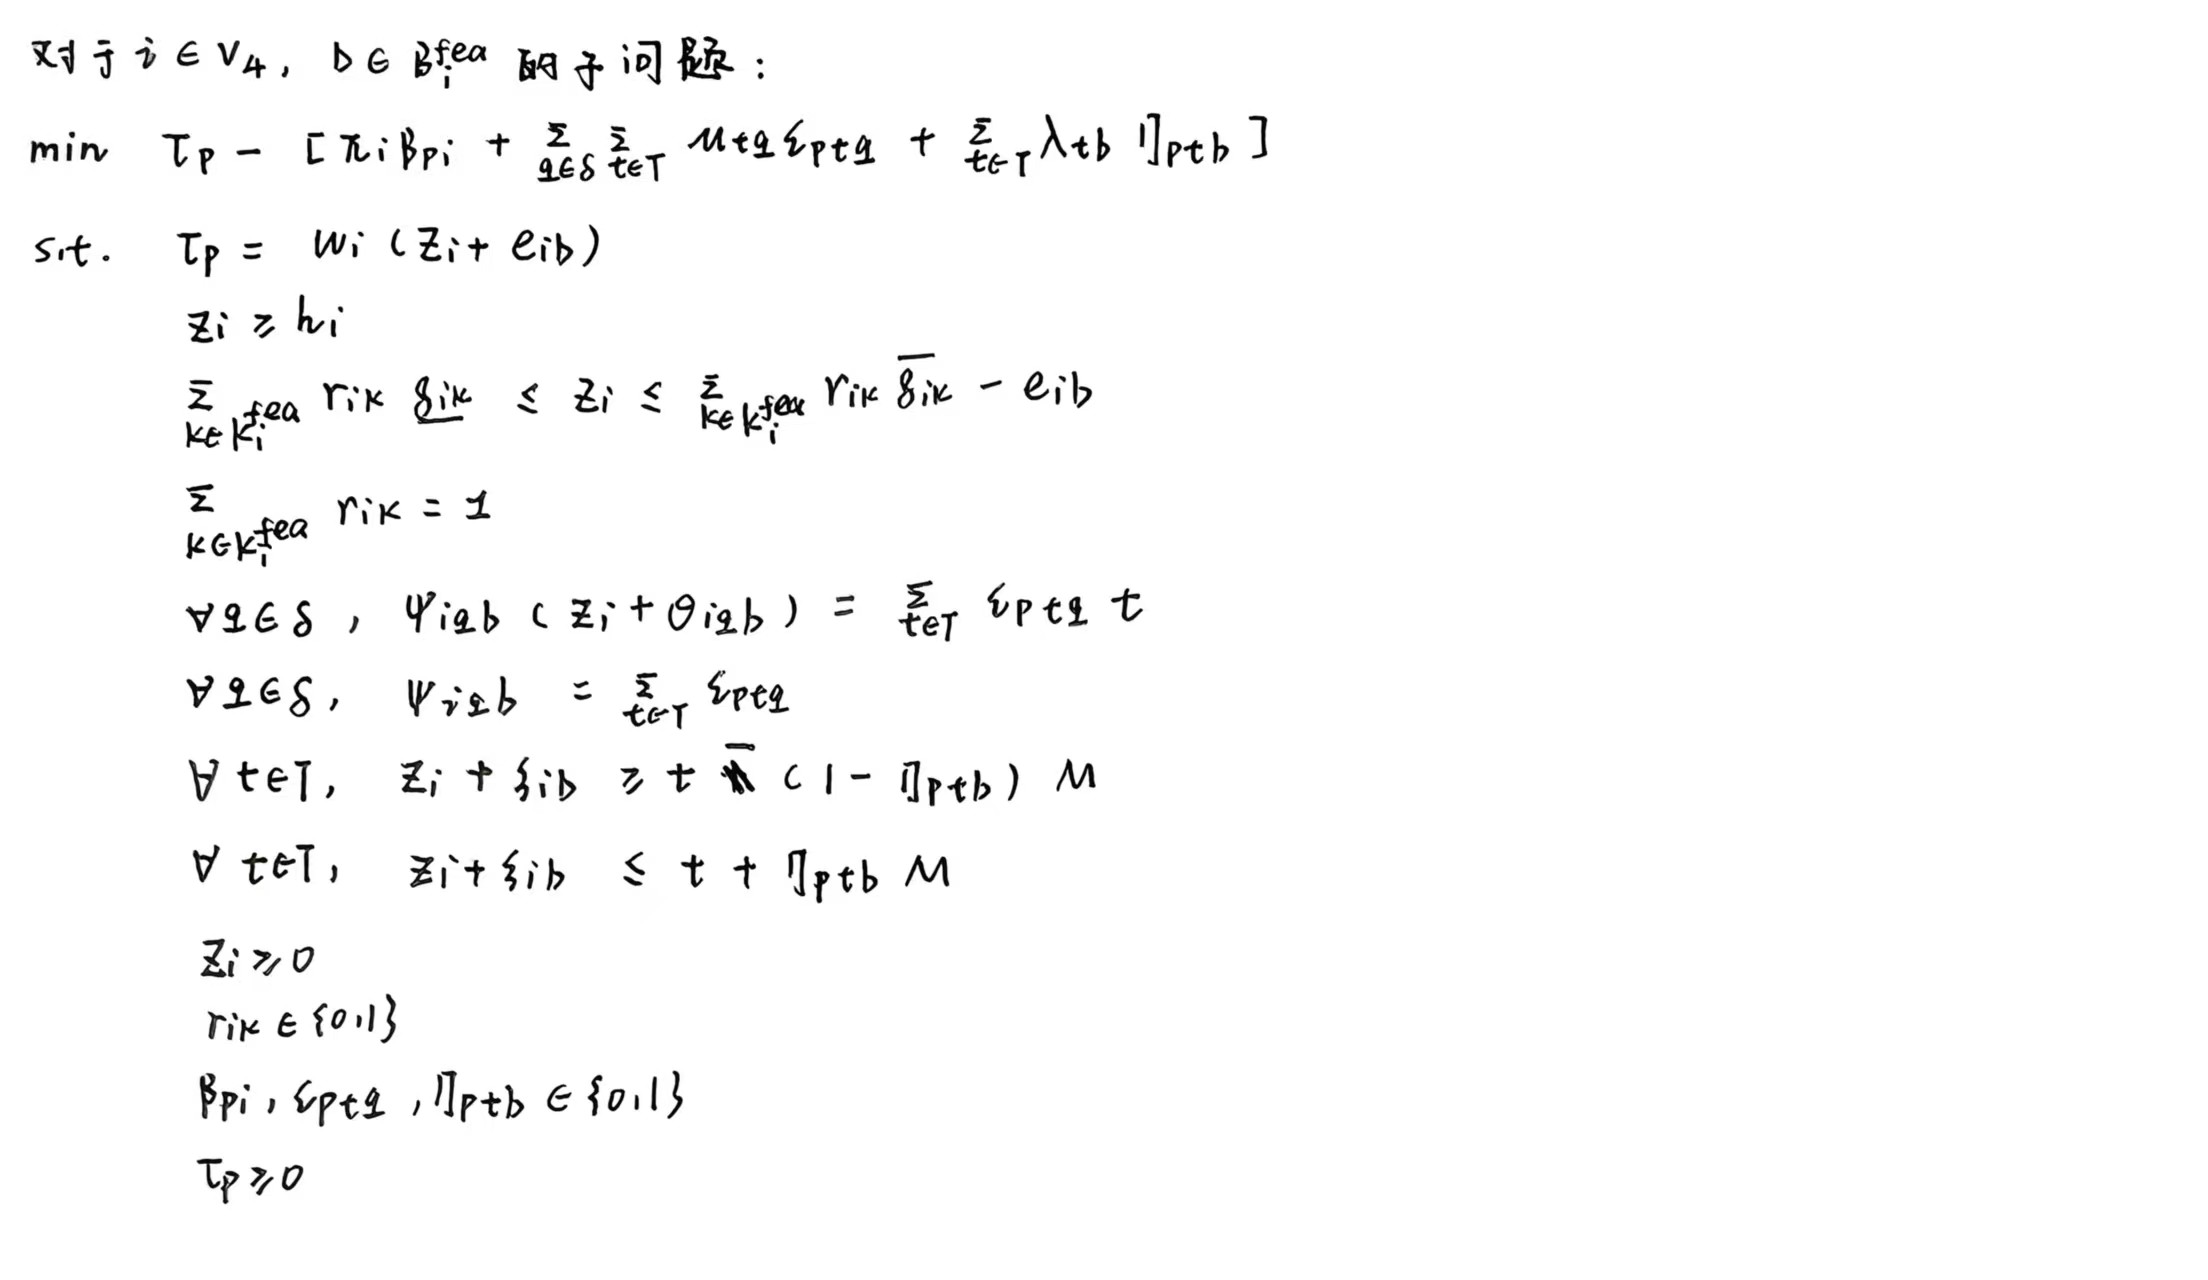
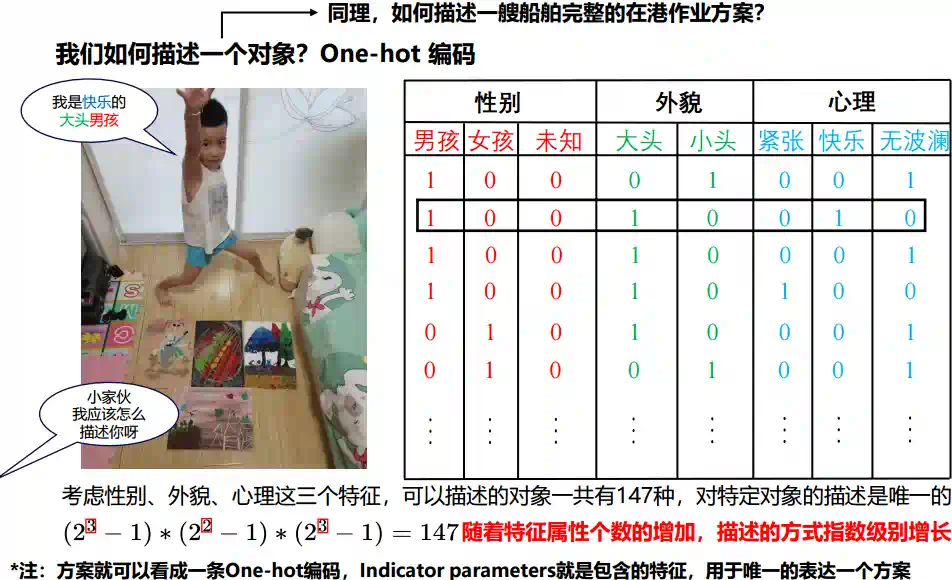
做这一部分关于集划分、包裹和覆盖模型以及“方案”的新理解
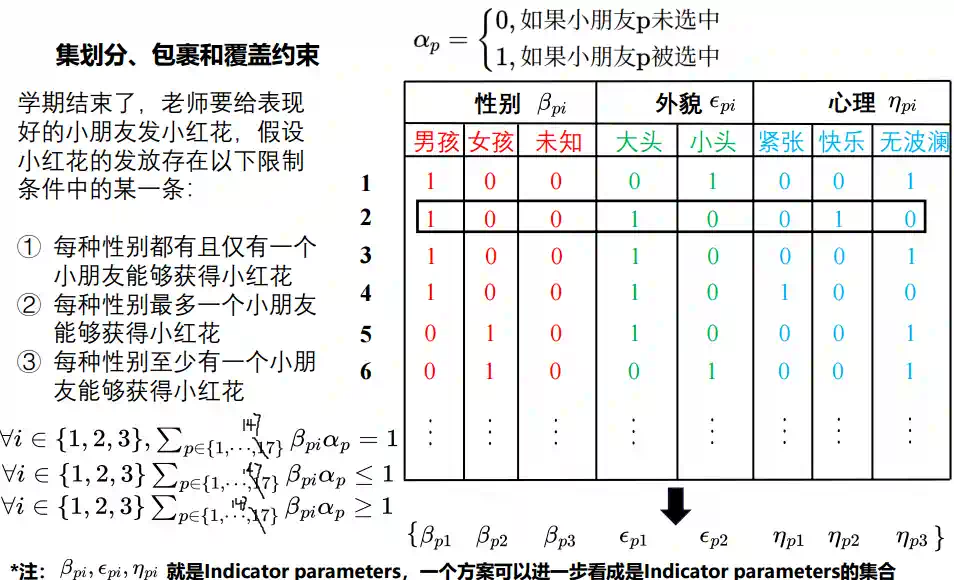
- 第一类限制条件是每种性别都有且仅有一个小朋友能够获得小红花
- 第二类限制条件是每种性别最多一个小朋友能够获得小红花
- 第三类限制条件是每种性别至少有一个小朋友能够获得小红花
我们应该如何表示上述约束呢?为此,我们引入一些记号,将性别这个特征用0-1参数
理解的进一步更新:方案也不一定完全是indicator parameters的集合,也可以有一些数量参数,就像机器学习中的哪些数值类型特征一样,参考高振迪的论文《Scheduling of automated ore terminal operations based on fixed inflow rhythm》
列生成算法的一些改进思路
刘保利老师港口管理优化与决策课程上给出了以下改进思路:
- 初始列可以通过启发式方法获得
- 每次迭代添加多的列
- 子问题用启发式算法快速求解,找检验数小于0的列(min问题)加入,如果找不到,再用精确解算法重新解子问题,如果能找到就加入新列,还是找不到就不用加了
- 迭代过程中多次没有入基的列剔除掉(这个东西编程咋实现)
- 引入支配规则,被支配的列不需要加入RMP,或者如果被支配的列以及在RMP中了,把这样的列删掉
当时上课找刘老师问的一个问题
如果主问题中包含0-1变量,我们使用列生成之前得先把主问题给线性松弛掉嘛,为什么不能加对这样的变量加上
D-W分解与列生成算法
引言
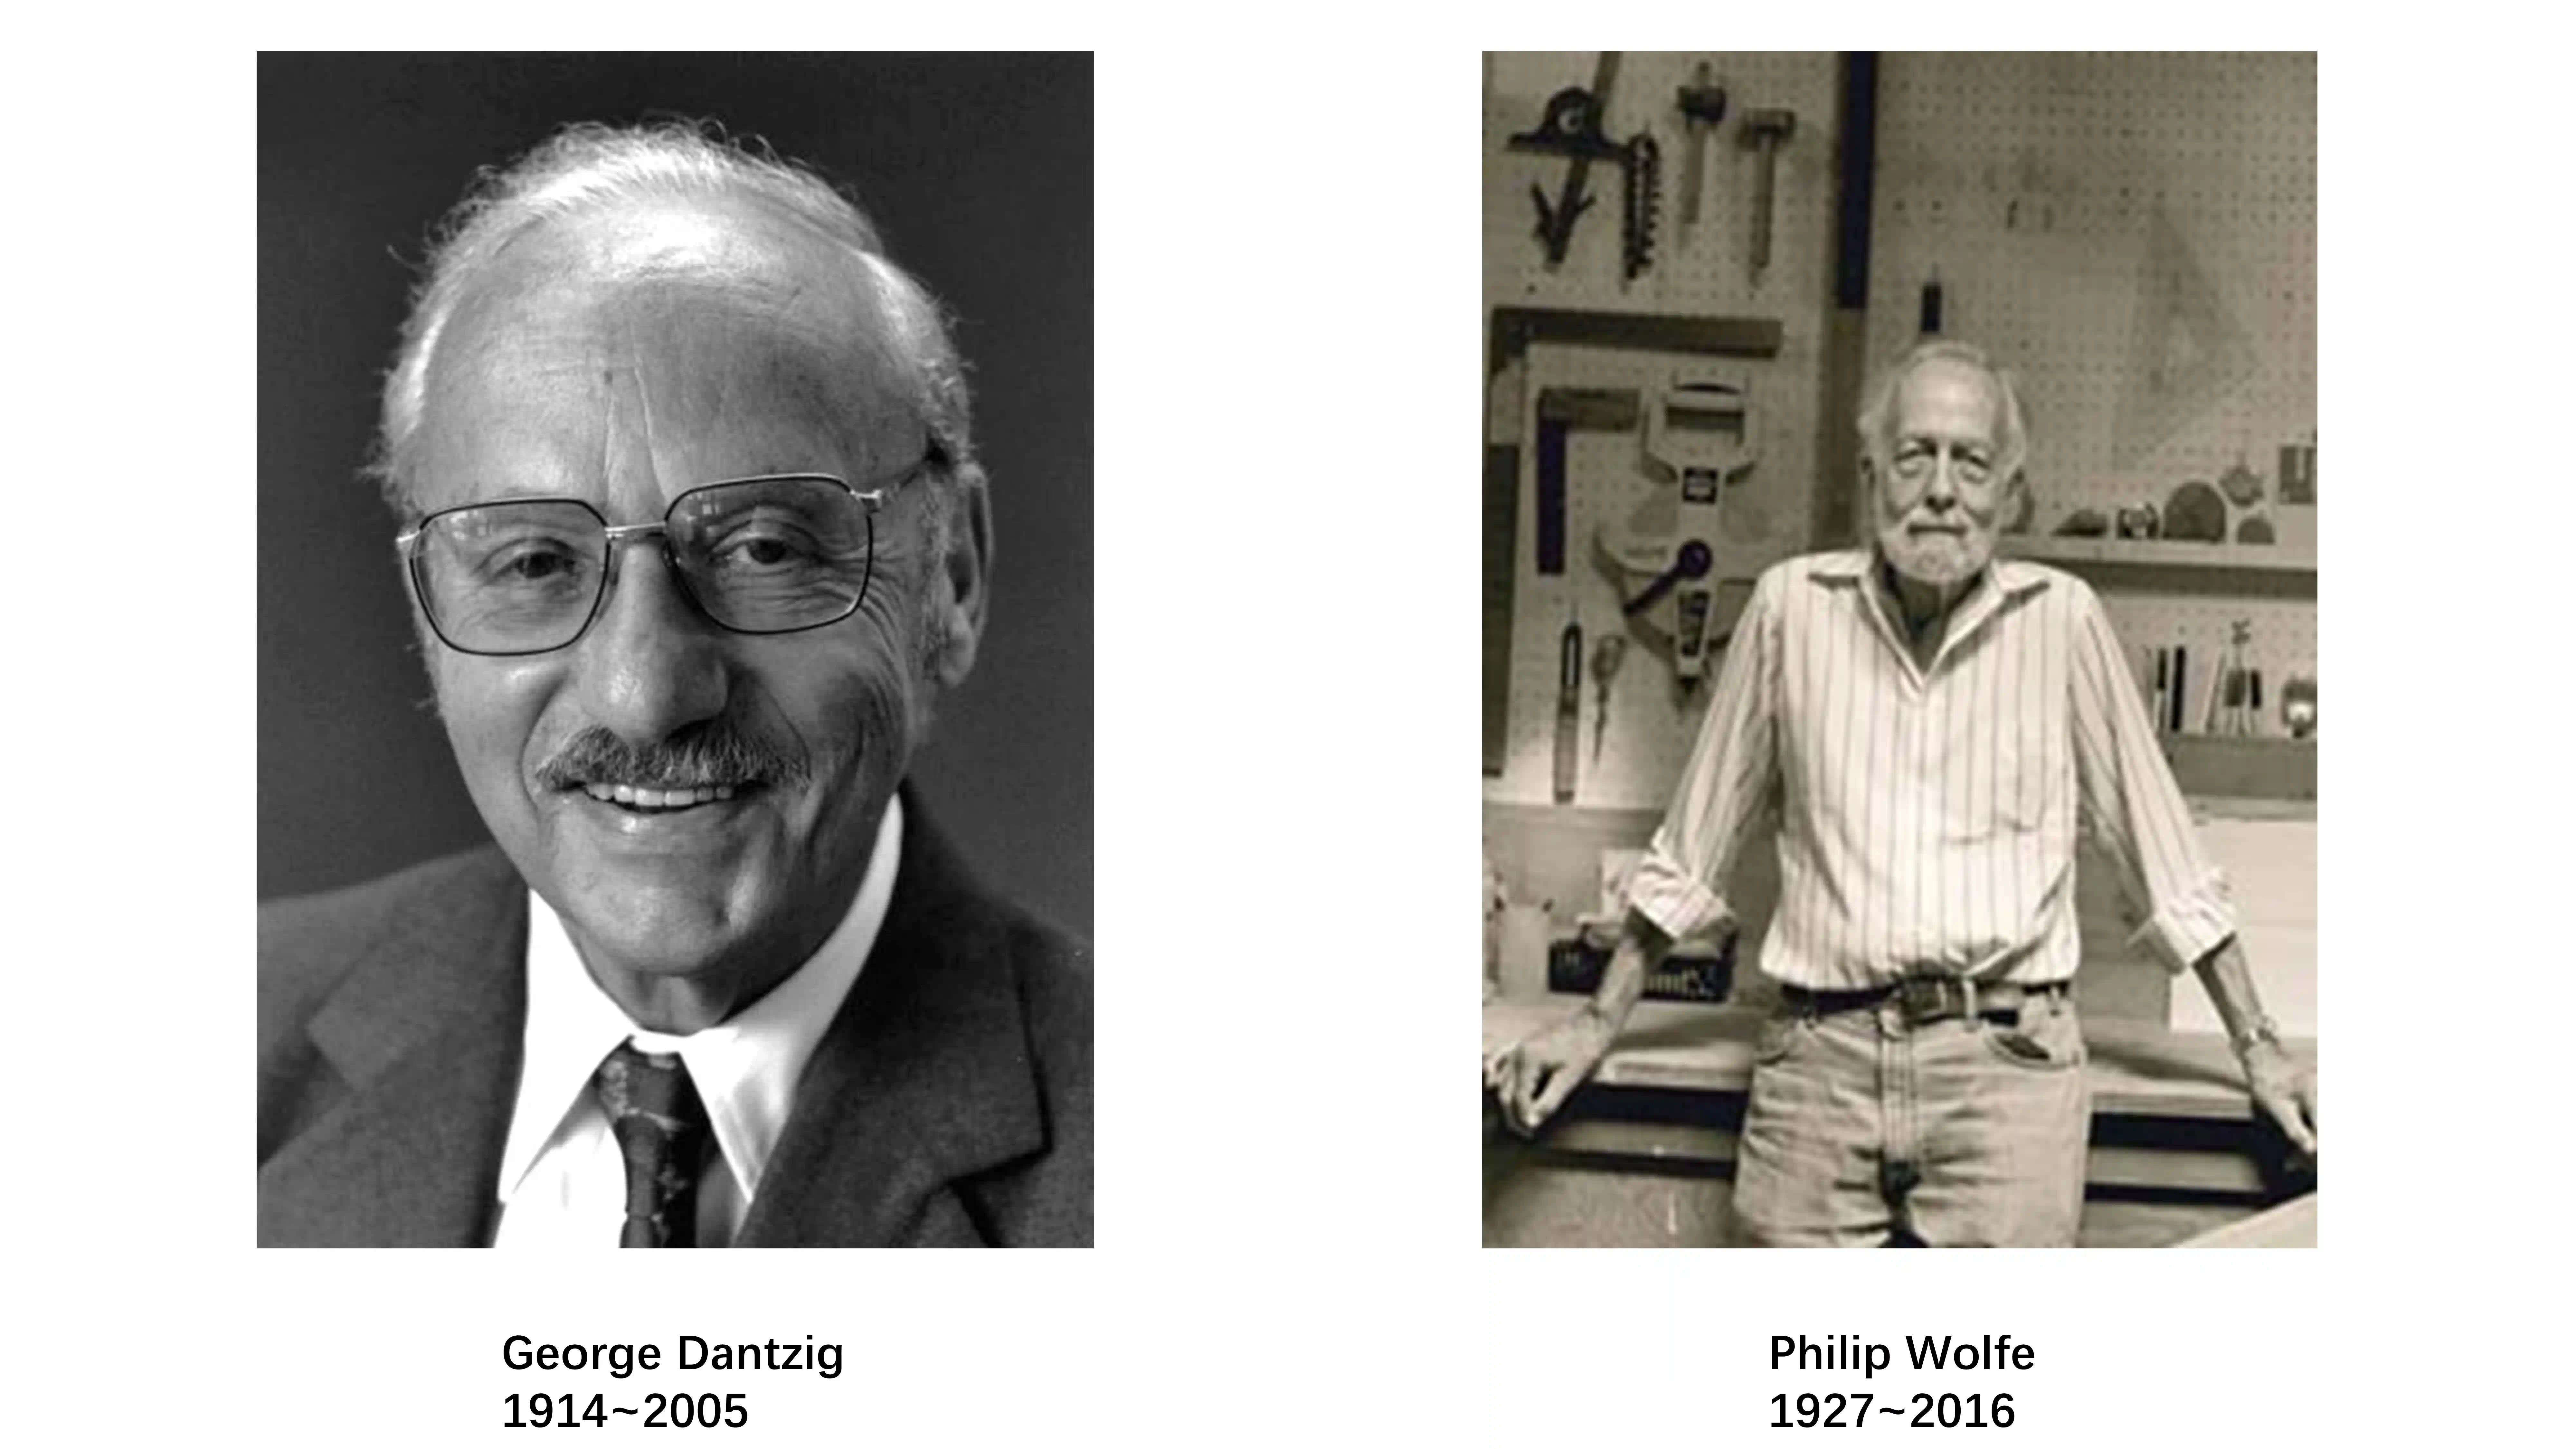
D-W分解是单纯性法创始人Dantizg和凸优化理论创始人Wolfe在上世纪60年代提出的一种针对具有块状对角结构的大规模线性规划模型(P)的分解算法。这个方法的基本思想就是用Minkowski定理将(P)中简单约束集分解为该简单约束集极点的凸组合和极射线的非负组合,将模型做等价转换,从维度庞大的原始变量空间转换到维度低的多的凸组合空间。更重要的是,使用D-W对(P)进行分解后的模型(MP)又恰好能够使用列生成算法进行求解,且由于模型具有独特的块状对角结构,使得我们可以同时产生多个(这个个数就是简单约束对应矩阵块的个数)定价子问题并行计算,又进一步加速了列生成算法求解(MP)的进程。
关于一些缩写的说明
- P:Primal Problem,在本文指的就是还没有用D-W分解处理的那个原始的模型。
- MP:Master Problem,在本文指的是用D-W分解对P进行处理后得到的那个模型。
- RMP:Restricted Master Problem,这是列生成算法中的概念,指的就是只考虑MP中部分列时的模型。
- SP:Subproblem,这时列生成算法中的概念,指的是用来获取MP中列的定价子问题。
理论
Minkowski定理
Definition 1. 如果集合中某个点不能由该集合中任意两点的凸组合所表示,那么就说这个点是这个集合的一个极点。
Definition 2. 假设
Definition 3. 如果
Theorem 1. 任意多面体都可以分解为极点的凸组合加上极方向的非负组合。
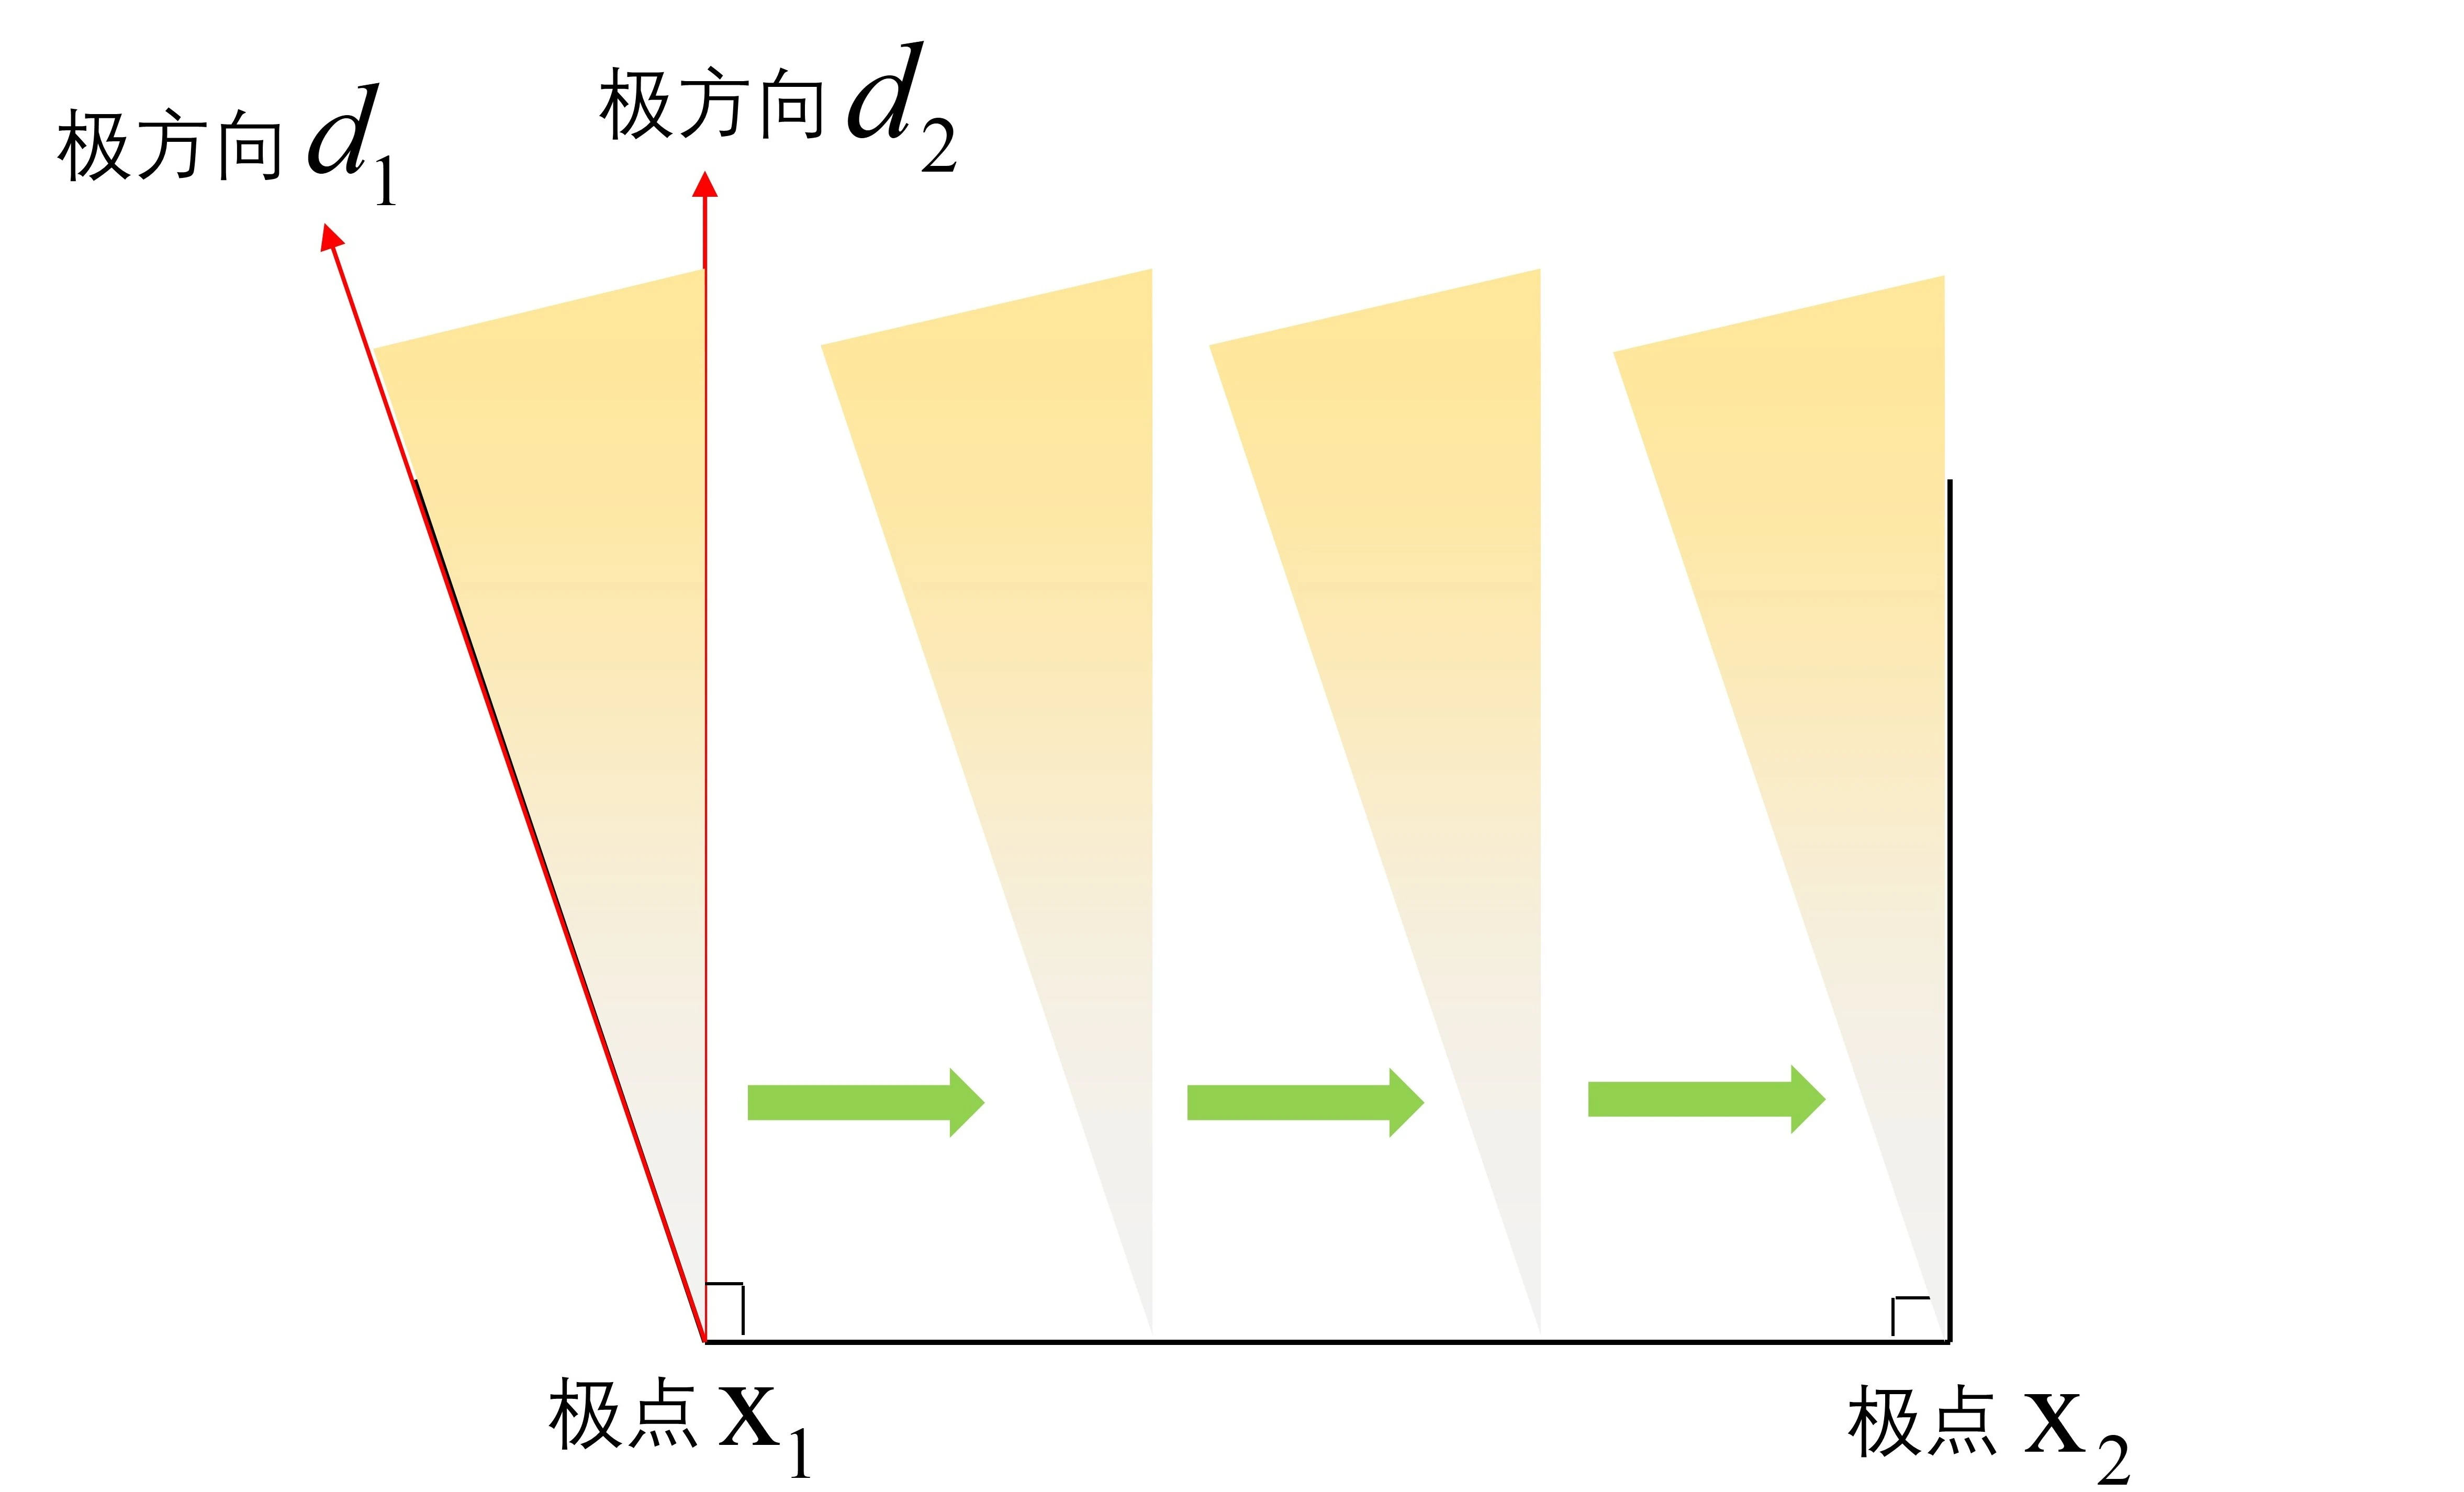
Minkowski定理的直观解释
以上图为例,极方向的非负组合张成的区域就像一个探照灯,假设我们手拿着探照灯,那么极点的凸组合就控制着手的位置,当我们将手从极点
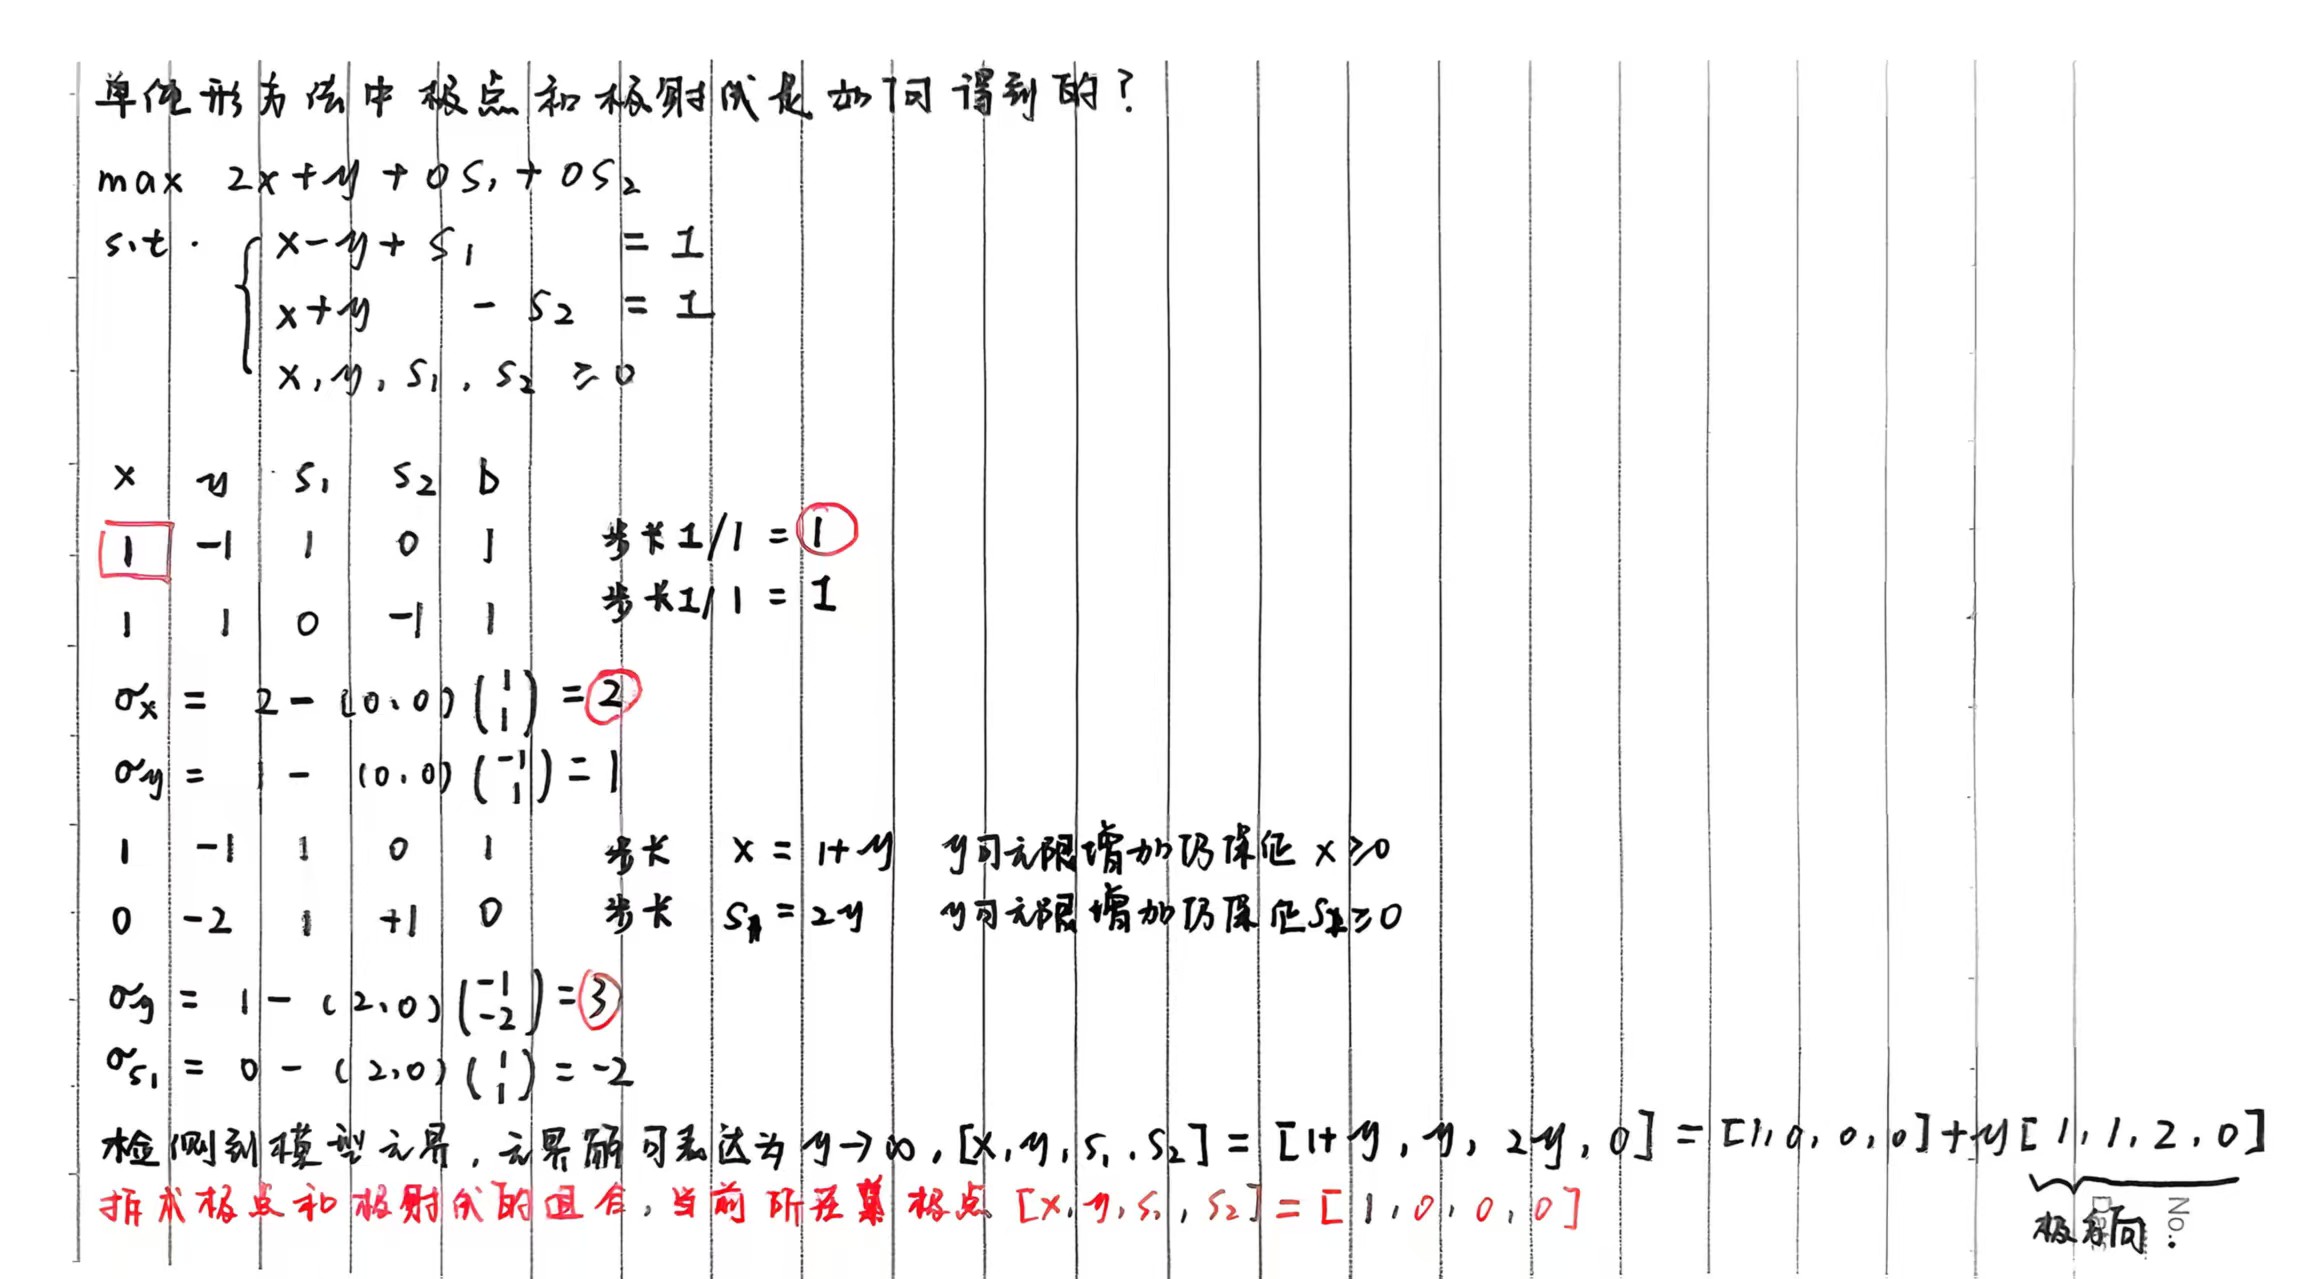
import gurobipy as gp
from gurobipy import GRB
# 创建模型
m = gp.Model("unbounded_lp")
m.Params.InfUnbdInfo = 1      # 打开无界或不可行信息日志
m.Params.DualReductions = 0   # 取消对偶缩减
# 定义变量(默认下界为0)
x = m.addVar(name="x", lb=0)
y = m.addVar(name="y", lb=0)
s1 = m.addVar(name="s1", lb=0)
s2 = m.addVar(name="s2", lb=0)
# 设置目标函数(最大化 2x + y)
m.setObjective(2*x + y, GRB.MAXIMIZE)
m.addConstr(x - y + s1 == 1, "c1")
m.addConstr(x + y - s2 == 1, "c2")
# 求解
m.optimize()
# 检查状态
if m.Status == GRB.UNBOUNDED:
    print('找到极射线')
    print(m.getAttr('UnbdRay',m.getVars()))
D-W分解算法
适合用D-W分解处理的模型的特征
DW分解能处理的问题一定是对变量进行分组,然后对约束系数矩阵做对应分块处理之后出现块状对角结构的线性规划模型。约束系数矩阵中那些独立矩阵块
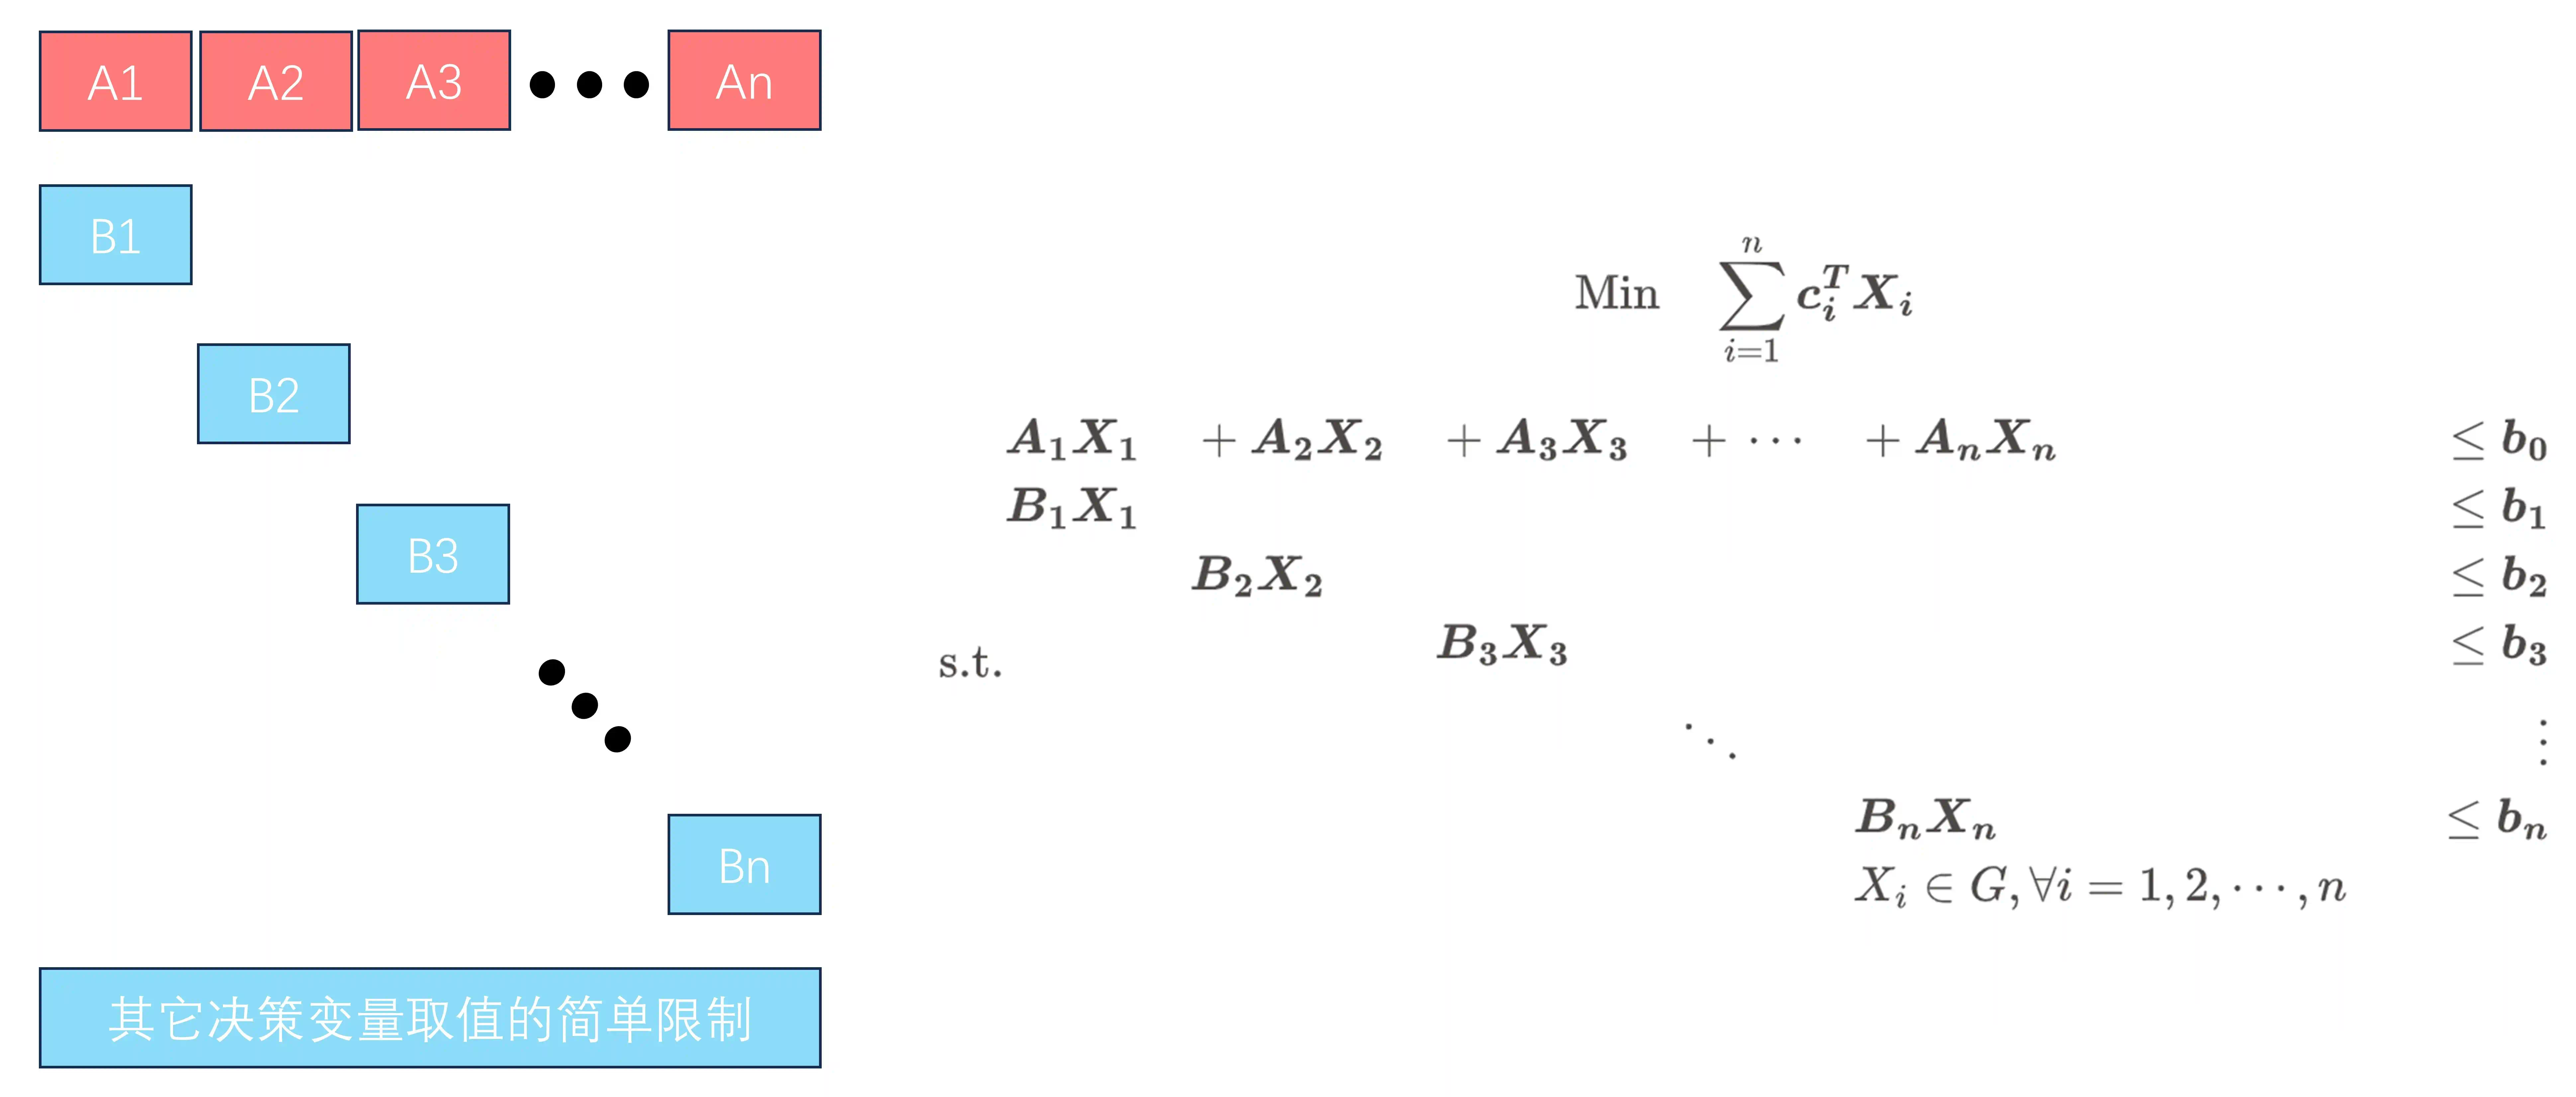
D-W分解的步骤
设
利用Minkowski定理分解简单约束集
对于第
根据Minkowski定理可将其分解为,
将分解结果代回原模型(P)
对结果稍加整理和变形,得到(MP),
使用列生成算法求解D-W分解得到的(MP)
记
注意到,(MP)模型中变量
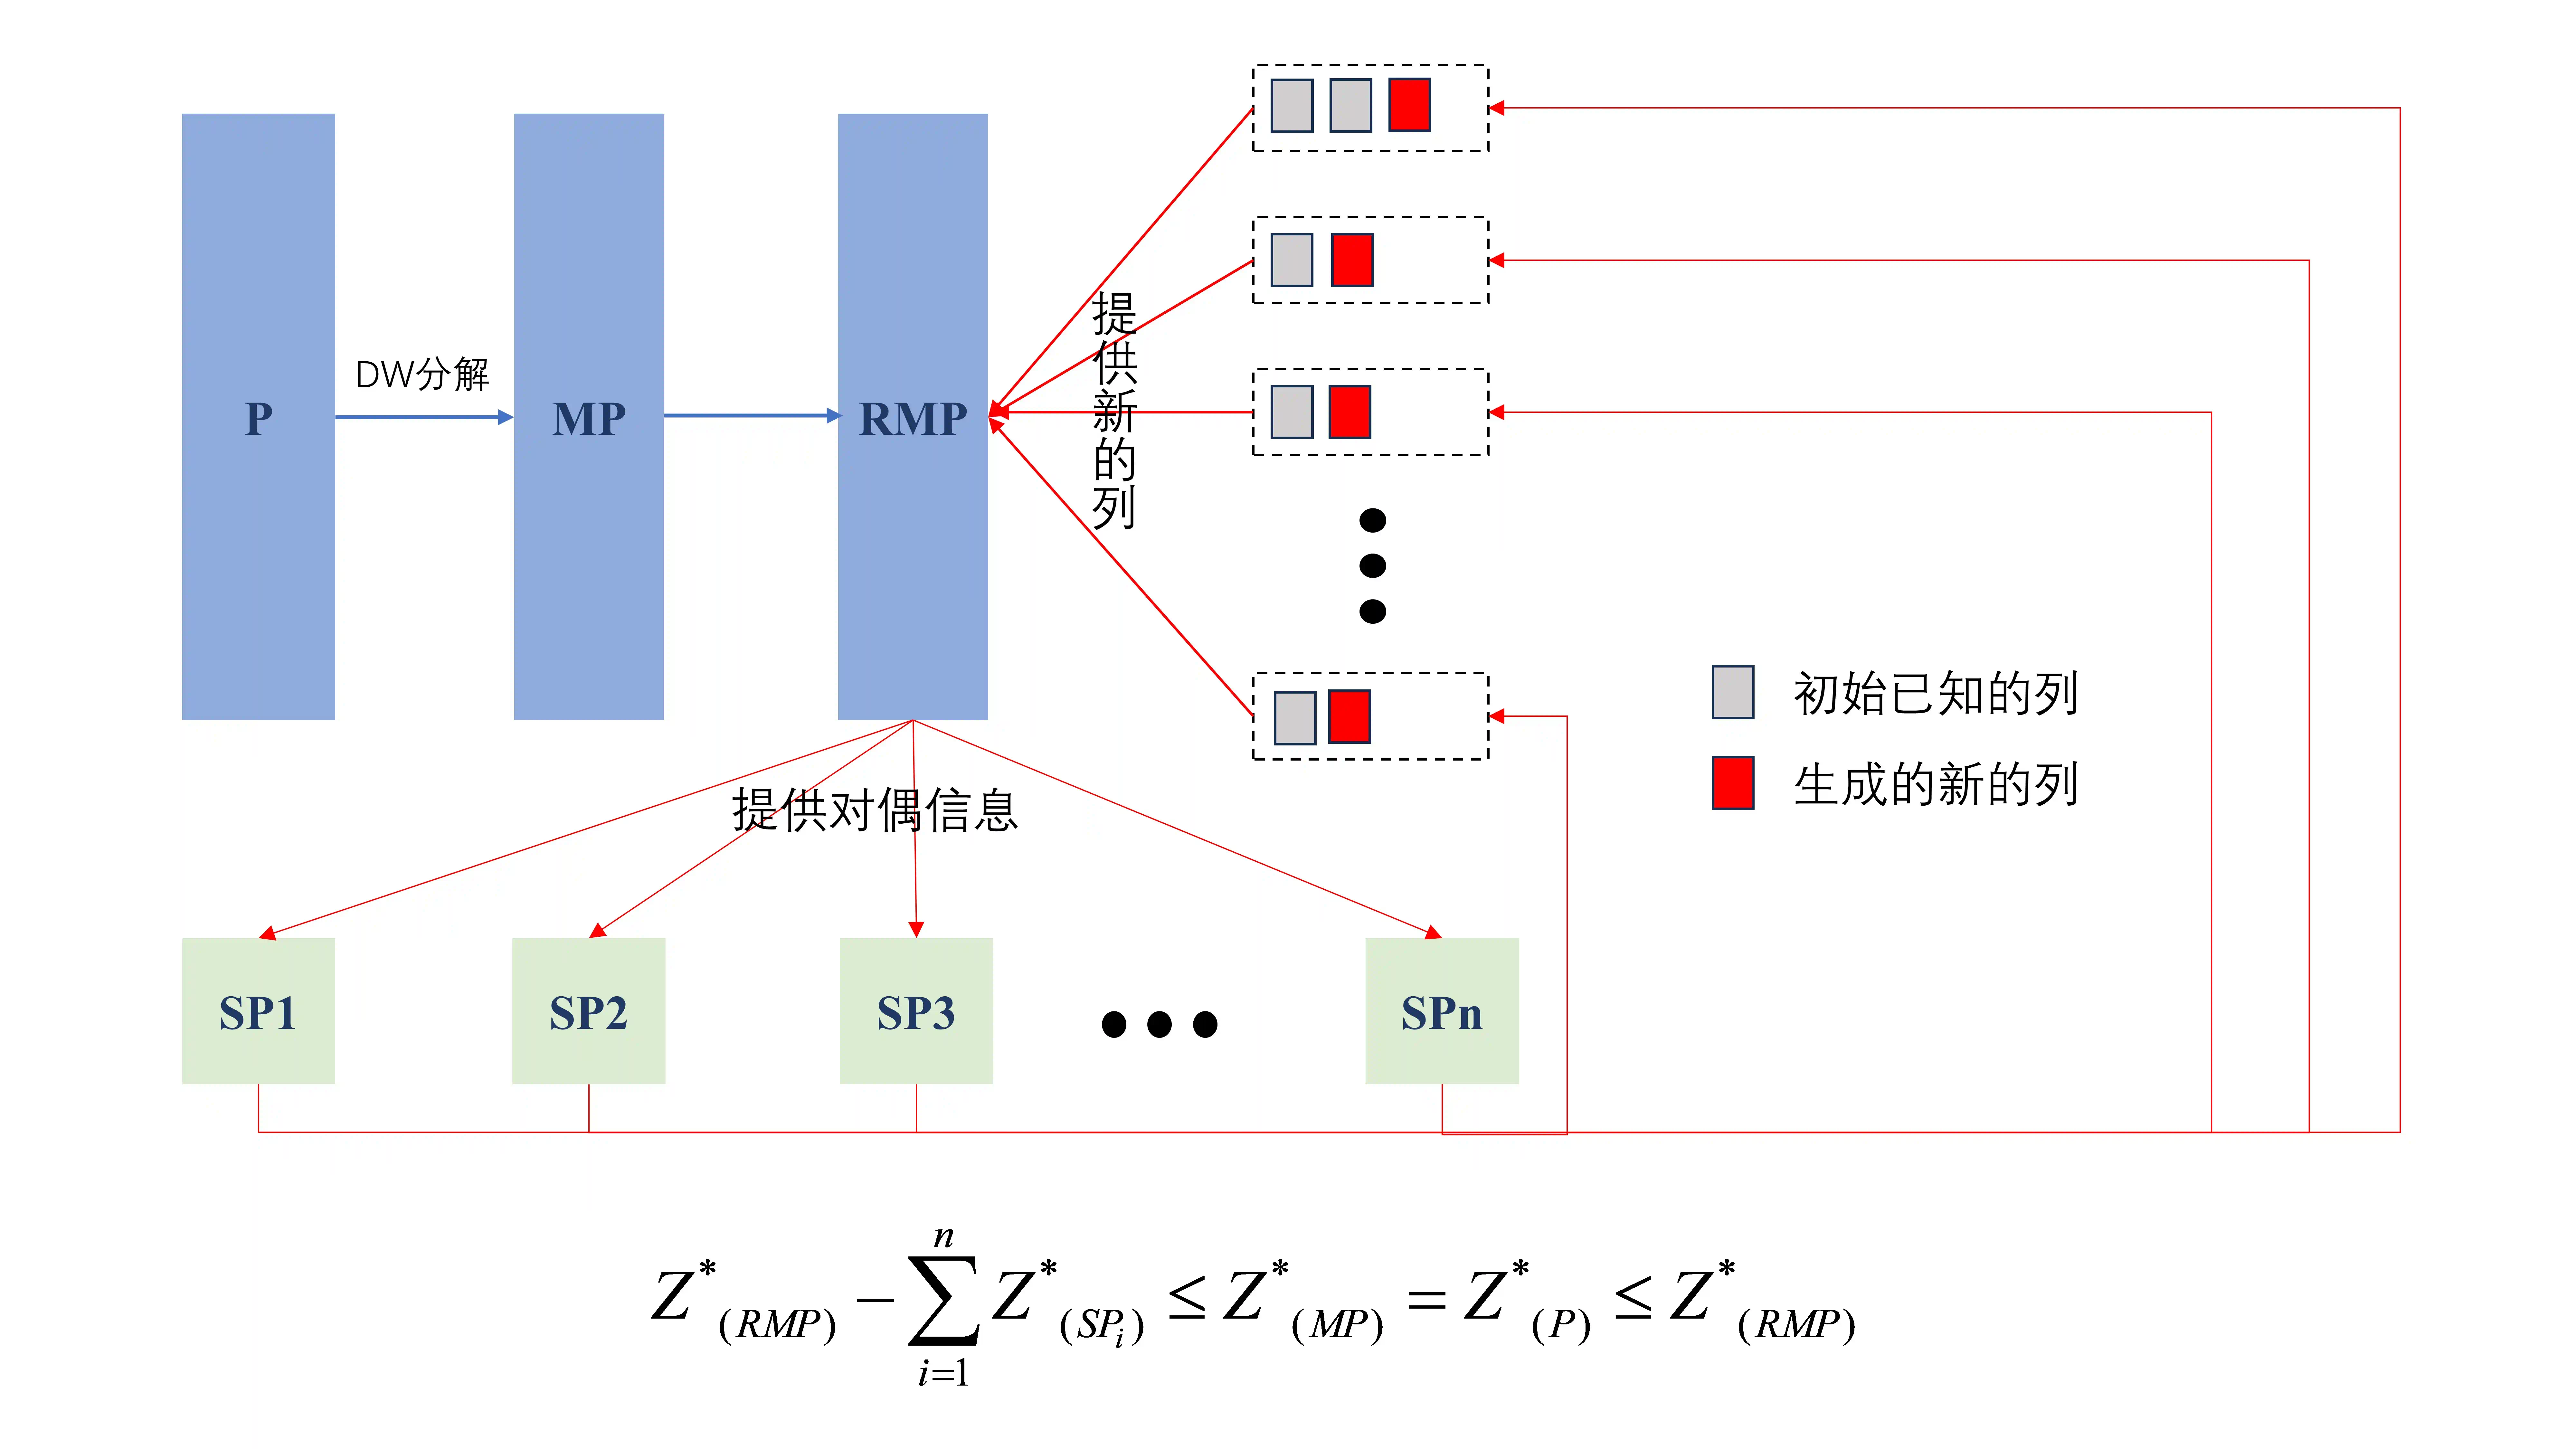
实战
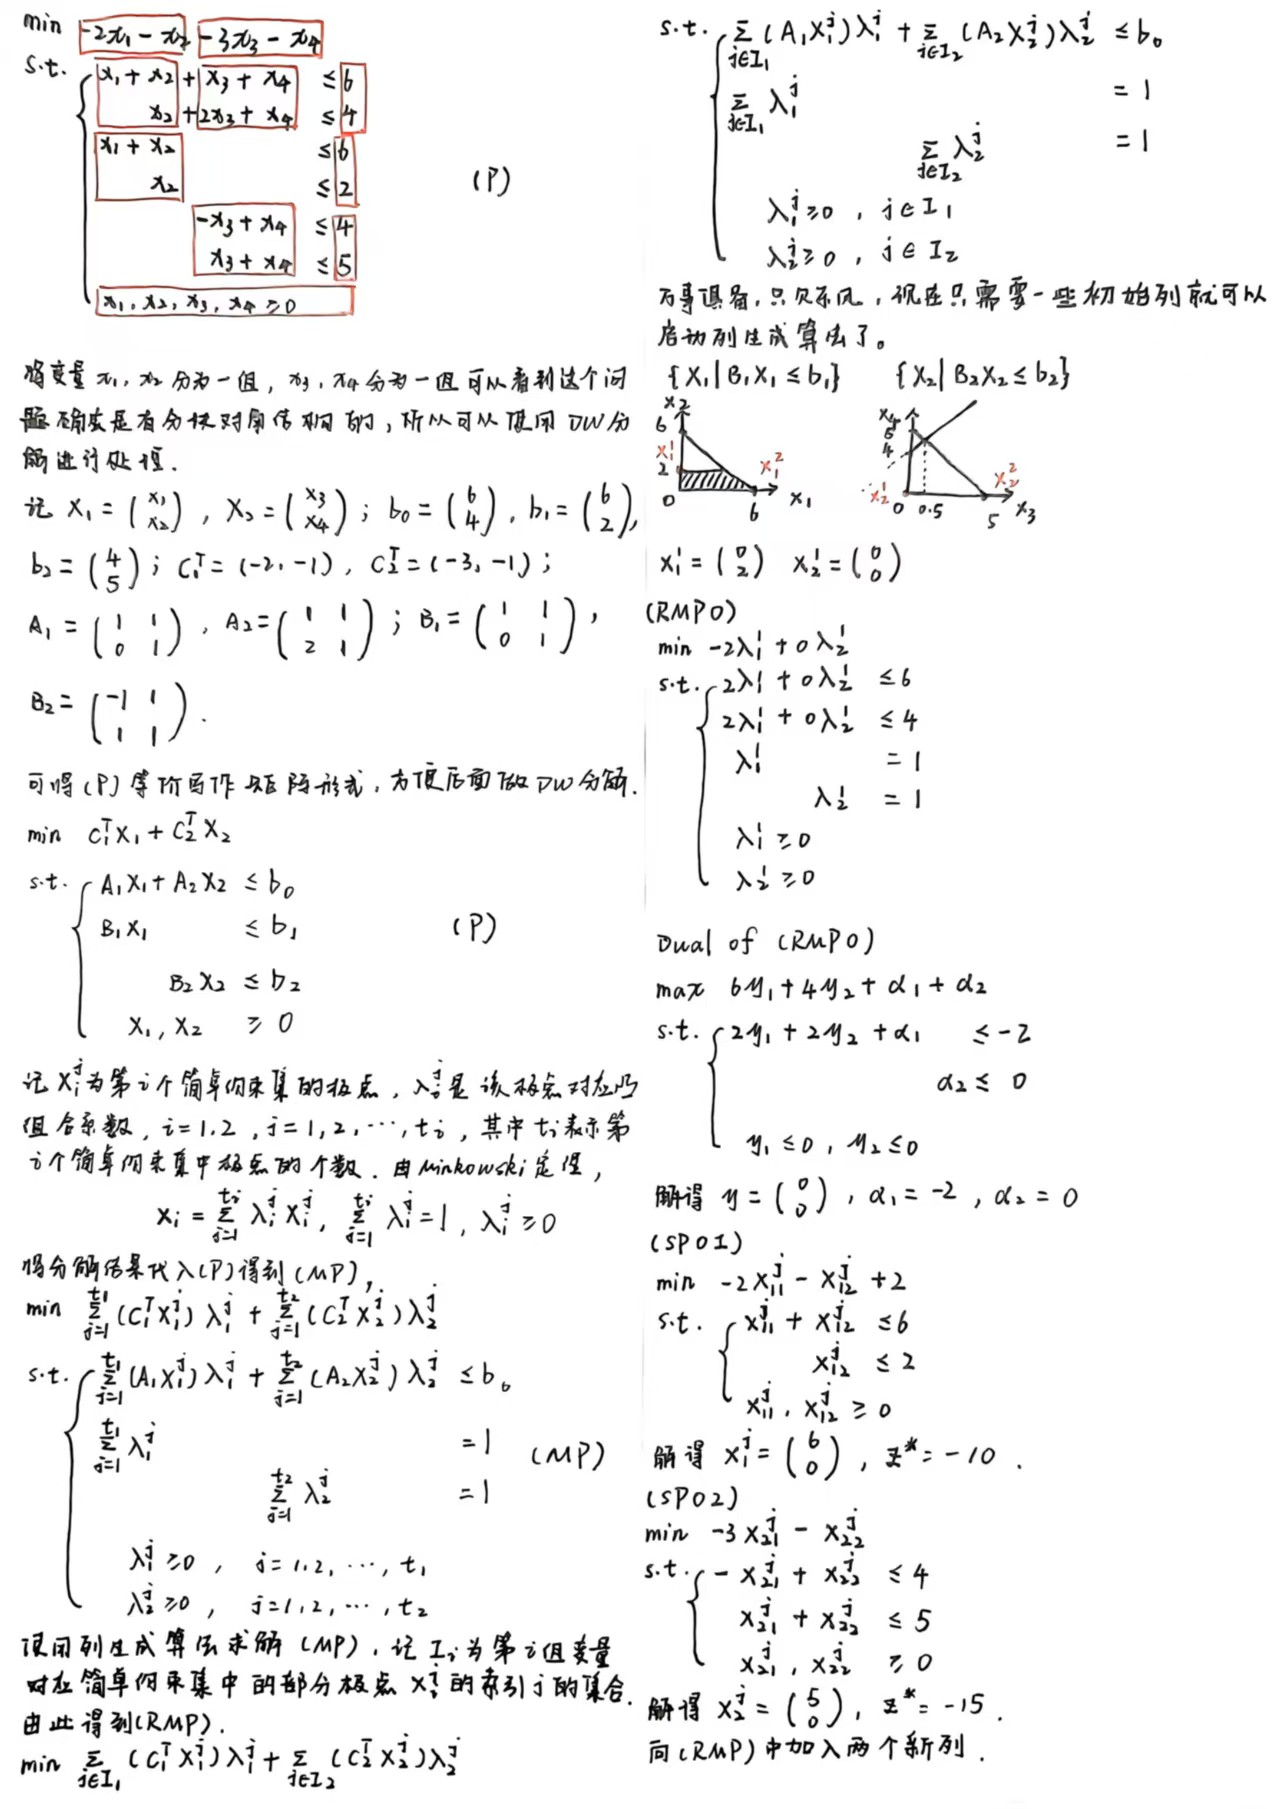
续上,
Benders分解与行生成算法
经典Benders分解与行生成
理论
这部分理解是有些问题的,留存一下当时的思考过程,就不删除了
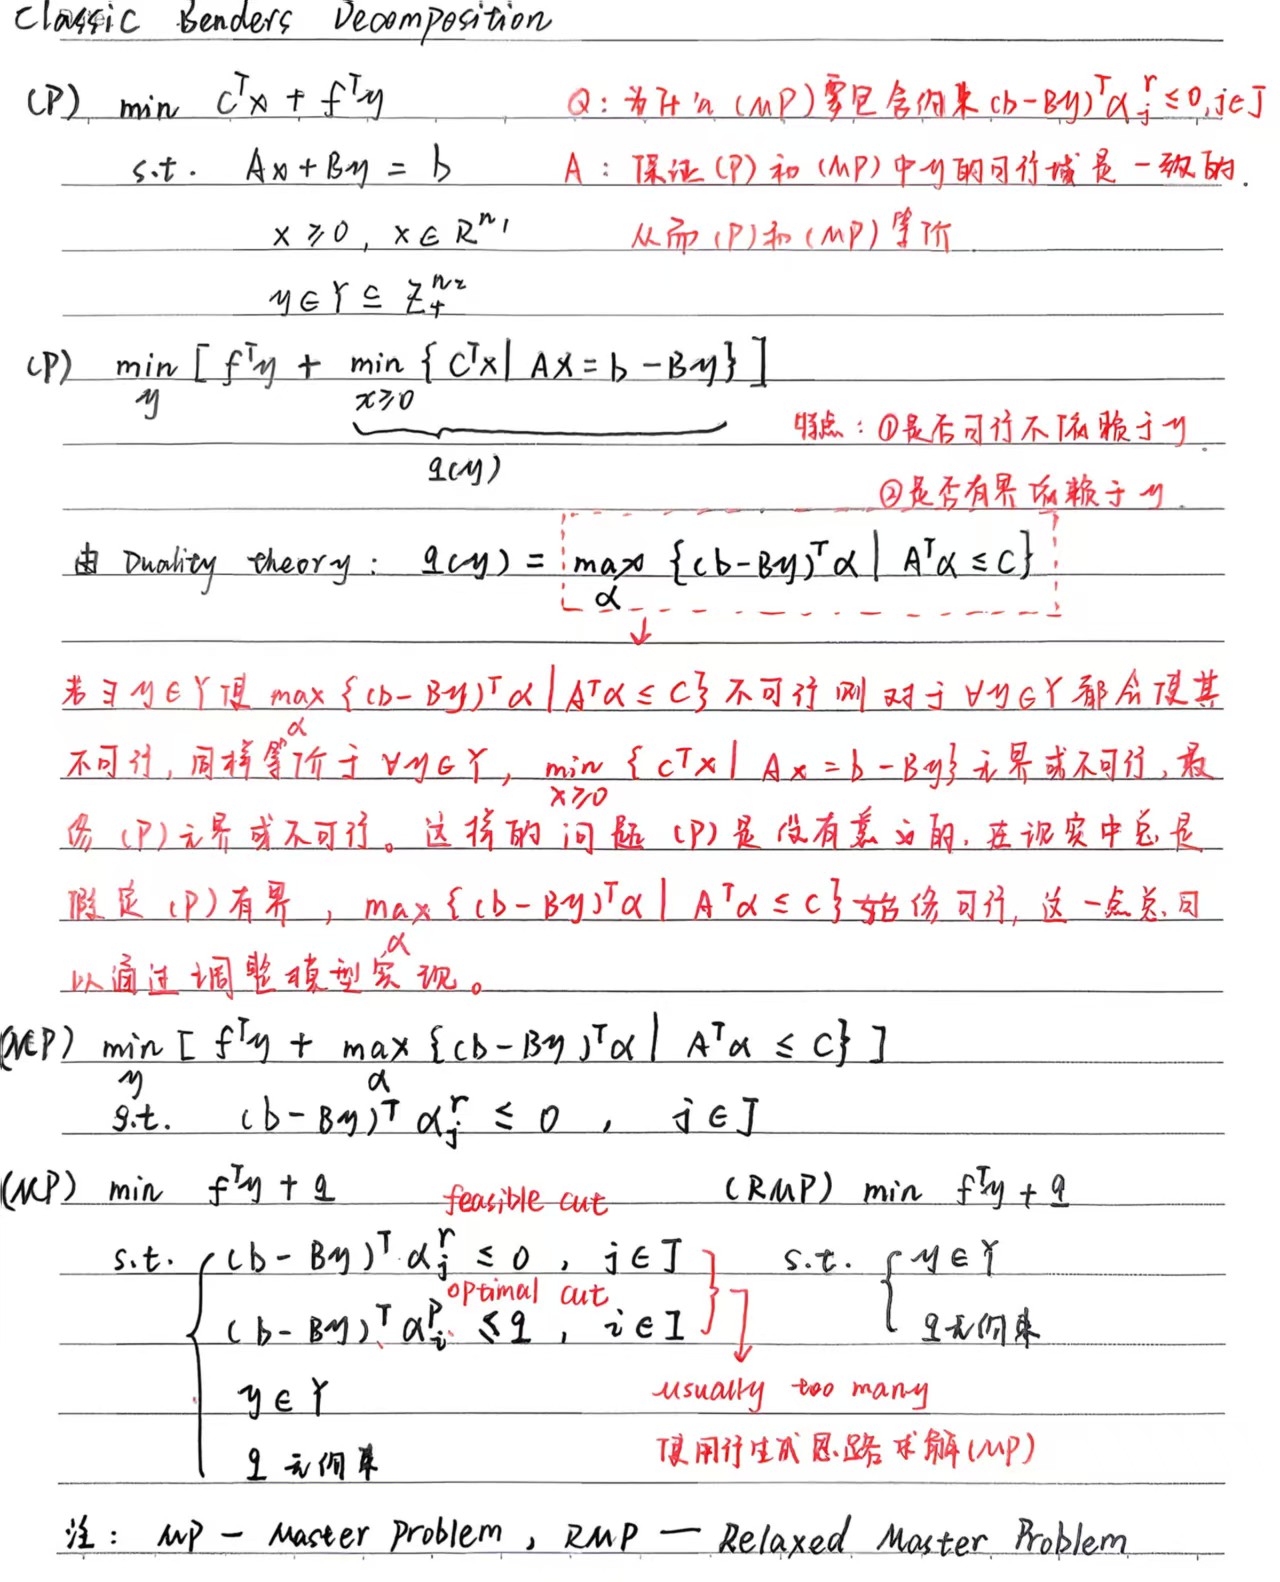
(MP)中加的极射线约束保证(MP)和(P)y的可行域是一样的?
一个
知乎上的回答和你想法一样:后来有一次跟英国的一个lecturer谈论,发现原来所谓的对偶,其实在本德斯里的作用是将子问题转化为约束可以添加到主问题
利用对偶理论对问题(P)做一系列的等价变形,将内层优化问题分解成内层优化问题的对偶对应的极点和极射线形成的约束,得到主问题(MP),我们现在要做的就是去求解(MP)。求解(MP)可能并不困难,但是把(MP)构造出来对于某些问题可能是非常困难的,因为极点和极射线的数量可能是非常多的,有可能是约束个数的指数级。回顾我们使用D-W分解后得到的模型列数特别多,我们使用了列生成算法求解,那行数特别多的问题当然就适合使用行生成,为此,我们把内层优化问题的对偶对应的极点和极射线形成的约束全部去掉,得到(MP)的松弛Relaxed Master Problem,还是记作(RMP)。注意,列生成中的(RMP)全称是Restricted Master Problem。根据松弛问题的定义,显然(RMP)为(MP)提供了一个下界,(RMP)的解不一定是(MP)的解。这就引申出两个问题:
- 如何判断(RMP)的解是不是(MP)的解,也就是说如何判断行生产应该结束了?
- 如果(RMP)的解不是(MP)的解,应该项(RMP)中添加什么约束把这样的解排除掉?
首先来分析(RMP)的解和(MP)解之间的关系。将内层优化问题定义为子问题(SP)
分析清楚(RMP)的解
- 将
代入(Dual of SP),如果(Dual of SP)是无界解,那就说明 违反了(Dual of SP)的极射线形成的约束, 不是(MP)的可行解。我们获取到相应的极射线,构造约束放回(RMP)即可排除这样的解,保证在以后的迭代中不在产生。这样的约束经常被叫做feasible cut,猜测这样命名的原因是因为它可以保证(Dual of SP)有界进而保证(SP)可行。 - 将
代入(Dual of SP),如果(Dual of SP)是有界解,观察(Dual of SP)的目标函数值 是否等于 ,如果不等,说明 不是(MP)的解,因为它不满足极点形成的约束。我们获取到相应的极点,构造约束放回(RMP)即可排除这样的解,保证在以后的迭代中不在产生。这样的约束经常被叫做optimal cut,猜测这样命名的原因是因为它是 逼近内层优化问题 的必要条件。如果 说明 是(MP)的最优解。
为什么
下界就是(RMP)解的目标函数值
总结一下,经典benders分解的步骤如下:
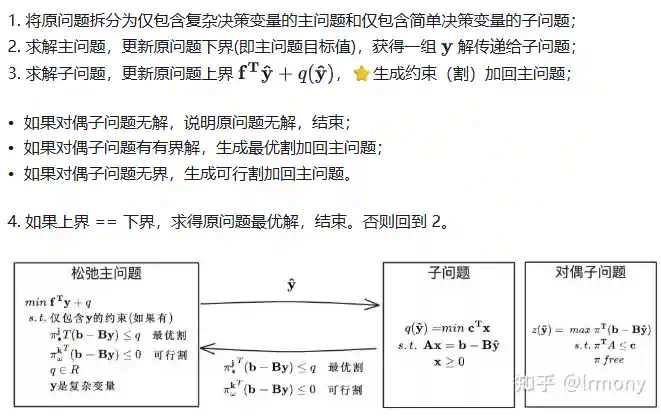
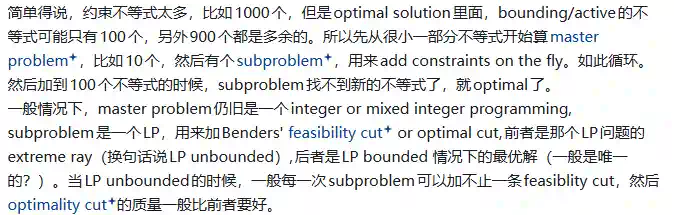
关于为什么benders分解算法可以加速求解,一句话说就是现实问题可能有上万约束,但是真正用来bounding最优解的可行就几百条,benders分解后的模型非常适合行生产求解,大幅度减少需要考虑的约束数量,只在有需要的时候才使用:
关于经典Benders分解适用场景的疑惑
为什么子问题不是线性规划就不能适用经典benders分解呢?因为经典benders分解的割是基于线性规划对偶得到的。
实战
下面看一个经典benders分解的具体例子:
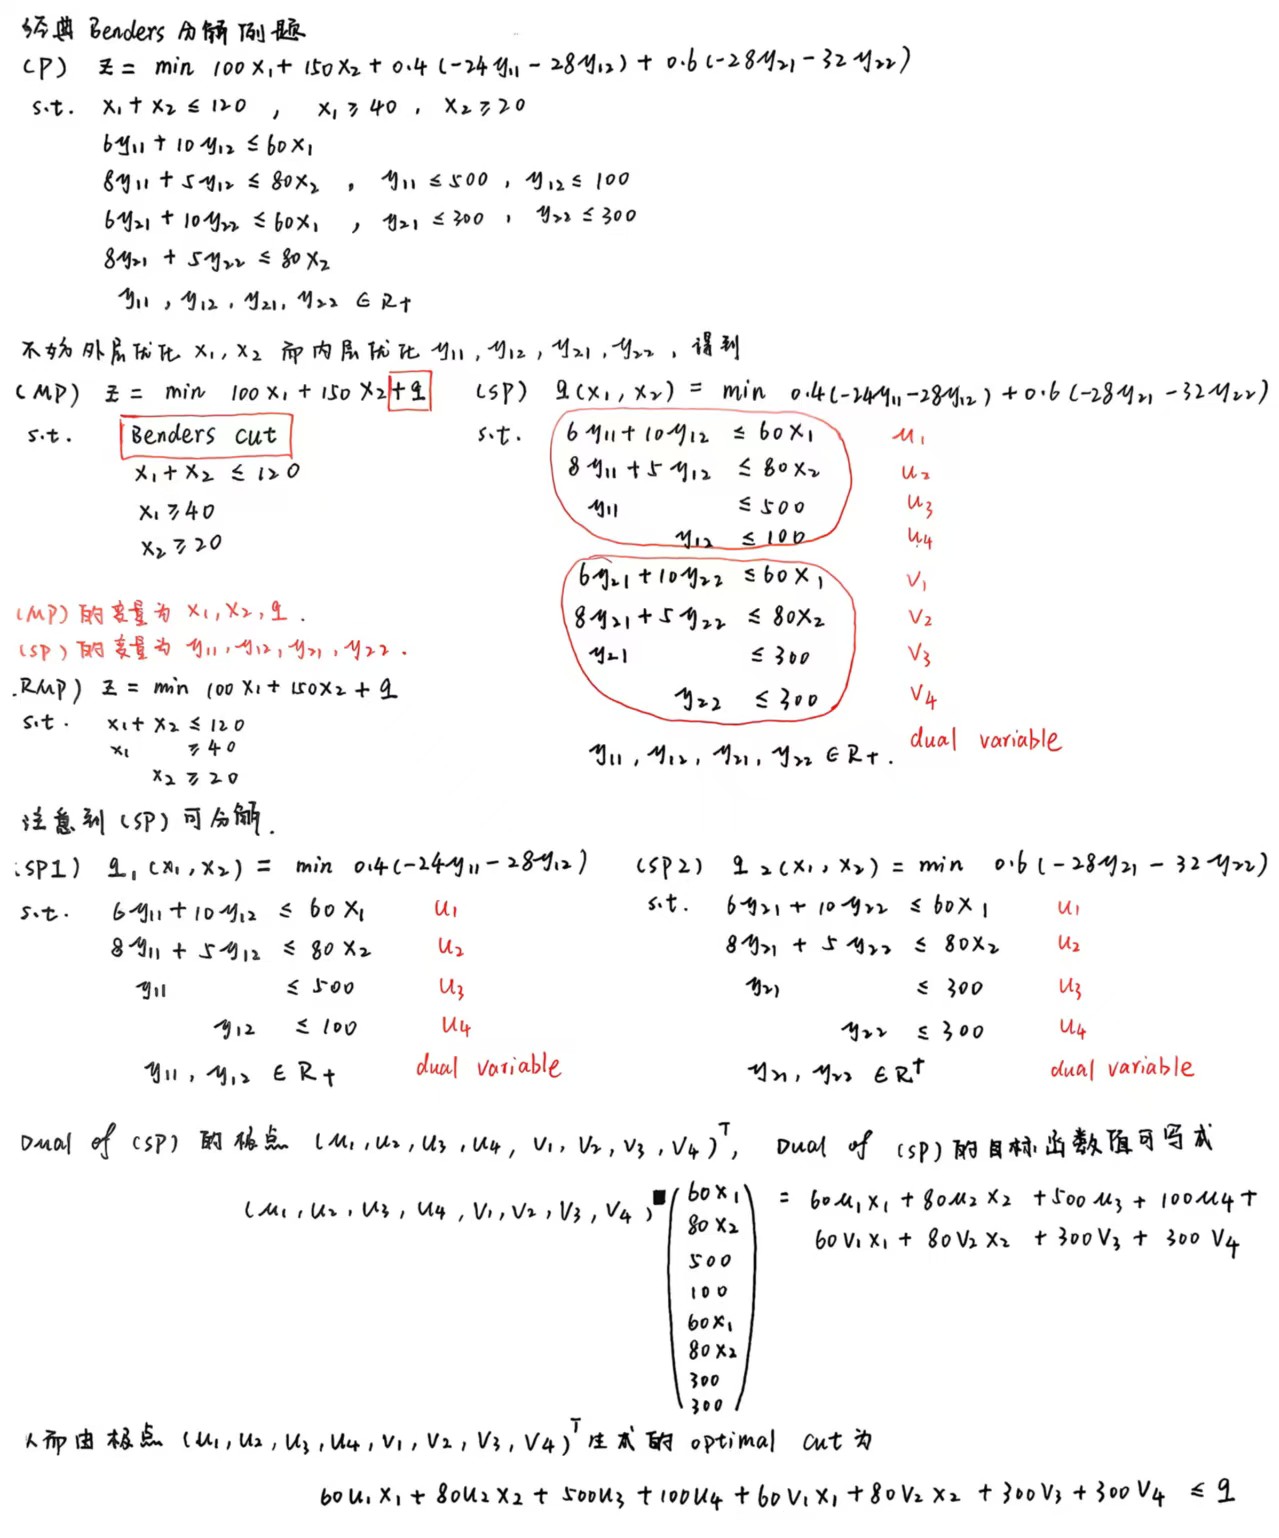
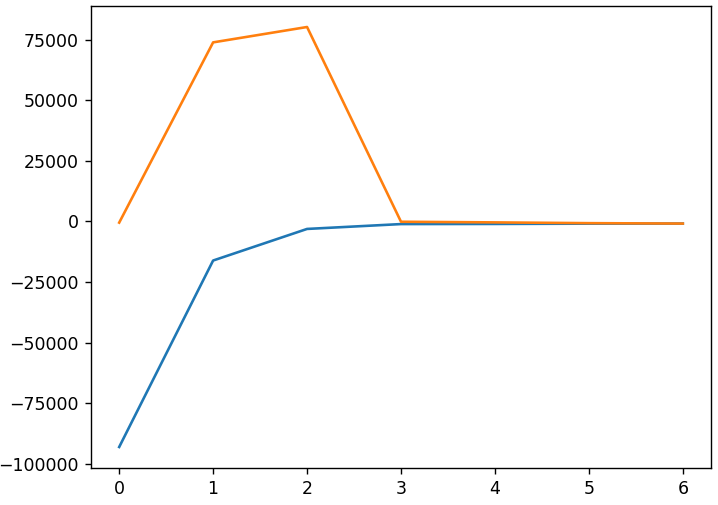
经典benders分解的例子1from gurobipy import *
from matplotlib import pyplot as plt
# 1. 构造松弛主问题
rmp_model = Model("relaxed master problem")
rmp_model.Params.LogToConsole = 0
q = rmp_model.addVar(vtype=GRB.CONTINUOUS,name='q',lb=-99999) # 初始q没有限制,可以取足够小的数
x = rmp_model.addVars([1,2],vtype=GRB.CONTINUOUS,lb=[40,20],name='x')
rmp_model.setObjective(
    100*x[1]+150*x[2]+q,
    sense = GRB.MINIMIZE
    )
# 2. 构造子问题
sp1_model = Model("subproblem1")
sp1_model.Params.LogToConsole = 0
y1 = sp1_model.addVars([1,2],vtype=GRB.CONTINUOUS,name='y1')
sp1_model.setObjective(
    0.4*(-24*y1[1]-28*y1[2]),
    sense = GRB.MINIMIZE
    )
sp1_model.addConstr(6*y1[1]+10*y1[2]<=60)
sp1_model.addConstr(8*y1[1]+5*y1[2]<=80)
sp1_model.addConstr(y1[1]<=500)
sp1_model.addConstr(y1[2]<=100)
sp2_model = Model("subproblem2")
sp2_model.Params.LogToConsole = 0
y2 = sp2_model.addVars([1,2],vtype=GRB.CONTINUOUS,name='y2')
sp2_model.setObjective(
    0.6*(-28*y2[1]-32*y2[2]),
    sense = GRB.MINIMIZE
    )
sp2_model.addConstr(6*y2[1]+10*y2[2]<=60)
sp2_model.addConstr(8*y2[1]+5*y2[2]<=80)
sp2_model.addConstr(y2[1]<=300)
sp2_model.addConstr(y2[2]<=300)
sp1_model.update()
sp2_model.update()
def updateSP(x):
    """
    在子问题中将主问题的变量固定住
    """
    sp1_model.getConstrs()[0].RHS = 60*x[0]
    sp1_model.getConstrs()[1].RHS = 80*x[1]
    sp2_model.getConstrs()[0].RHS = 60*x[0]
    sp2_model.getConstrs()[1].RHS = 80*x[1]

lb_his,ub_his = [],[] # 上下界更新历史
while True:
    # 3. 求解松弛主问题,将解传递给子问题固定住
    rmp_model.optimize()
    lb_his.append(rmp_model.ObjVal)
    q_value,x_value1,x_value2 = rmp_model.getAttr('X',rmp_model.getVars())
    updateSP([x_value1,x_value2])
    # 4. 求解子问题
    sp1_model.optimize()
    sp2_model.optimize()
    ub_his.append(sp1_model.ObjVal+sp2_model.ObjVal+100*x_value1+150*x_value2)
    u = sp1_model.getAttr('Pi',sp1_model.getConstrs())
    v = sp2_model.getAttr('Pi',sp2_model.getConstrs())
    # 5. 检查是否终止
    if abs(sp1_model.ObjVal+sp2_model.ObjVal-q_value) < 1e-3:
        break
    # 6. 构造最优割
    rmp_model.addConstr(60*u[0]*x[1]+80*u[1]*x[2]+500*u[2]+100*u[3]+\
        60*v[0]*x[1]+80*v[1]*x[2]+300*v[2]+300*v[3]<=q)

print("最优解目标函数值:",rmp_model.ObjVal)
print("最优解x1,x2:",rmp_model.getVars()[1:])
fig,ax = plt.subplots()
ax.plot(lb_his)
ax.plot(ub_his)
plt.show()
再看一个经典benders分解的例子,这个例子既要添加最优割,又要添加可行割:
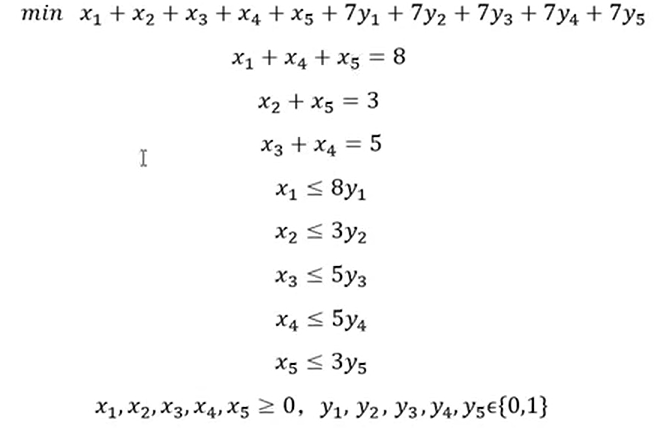
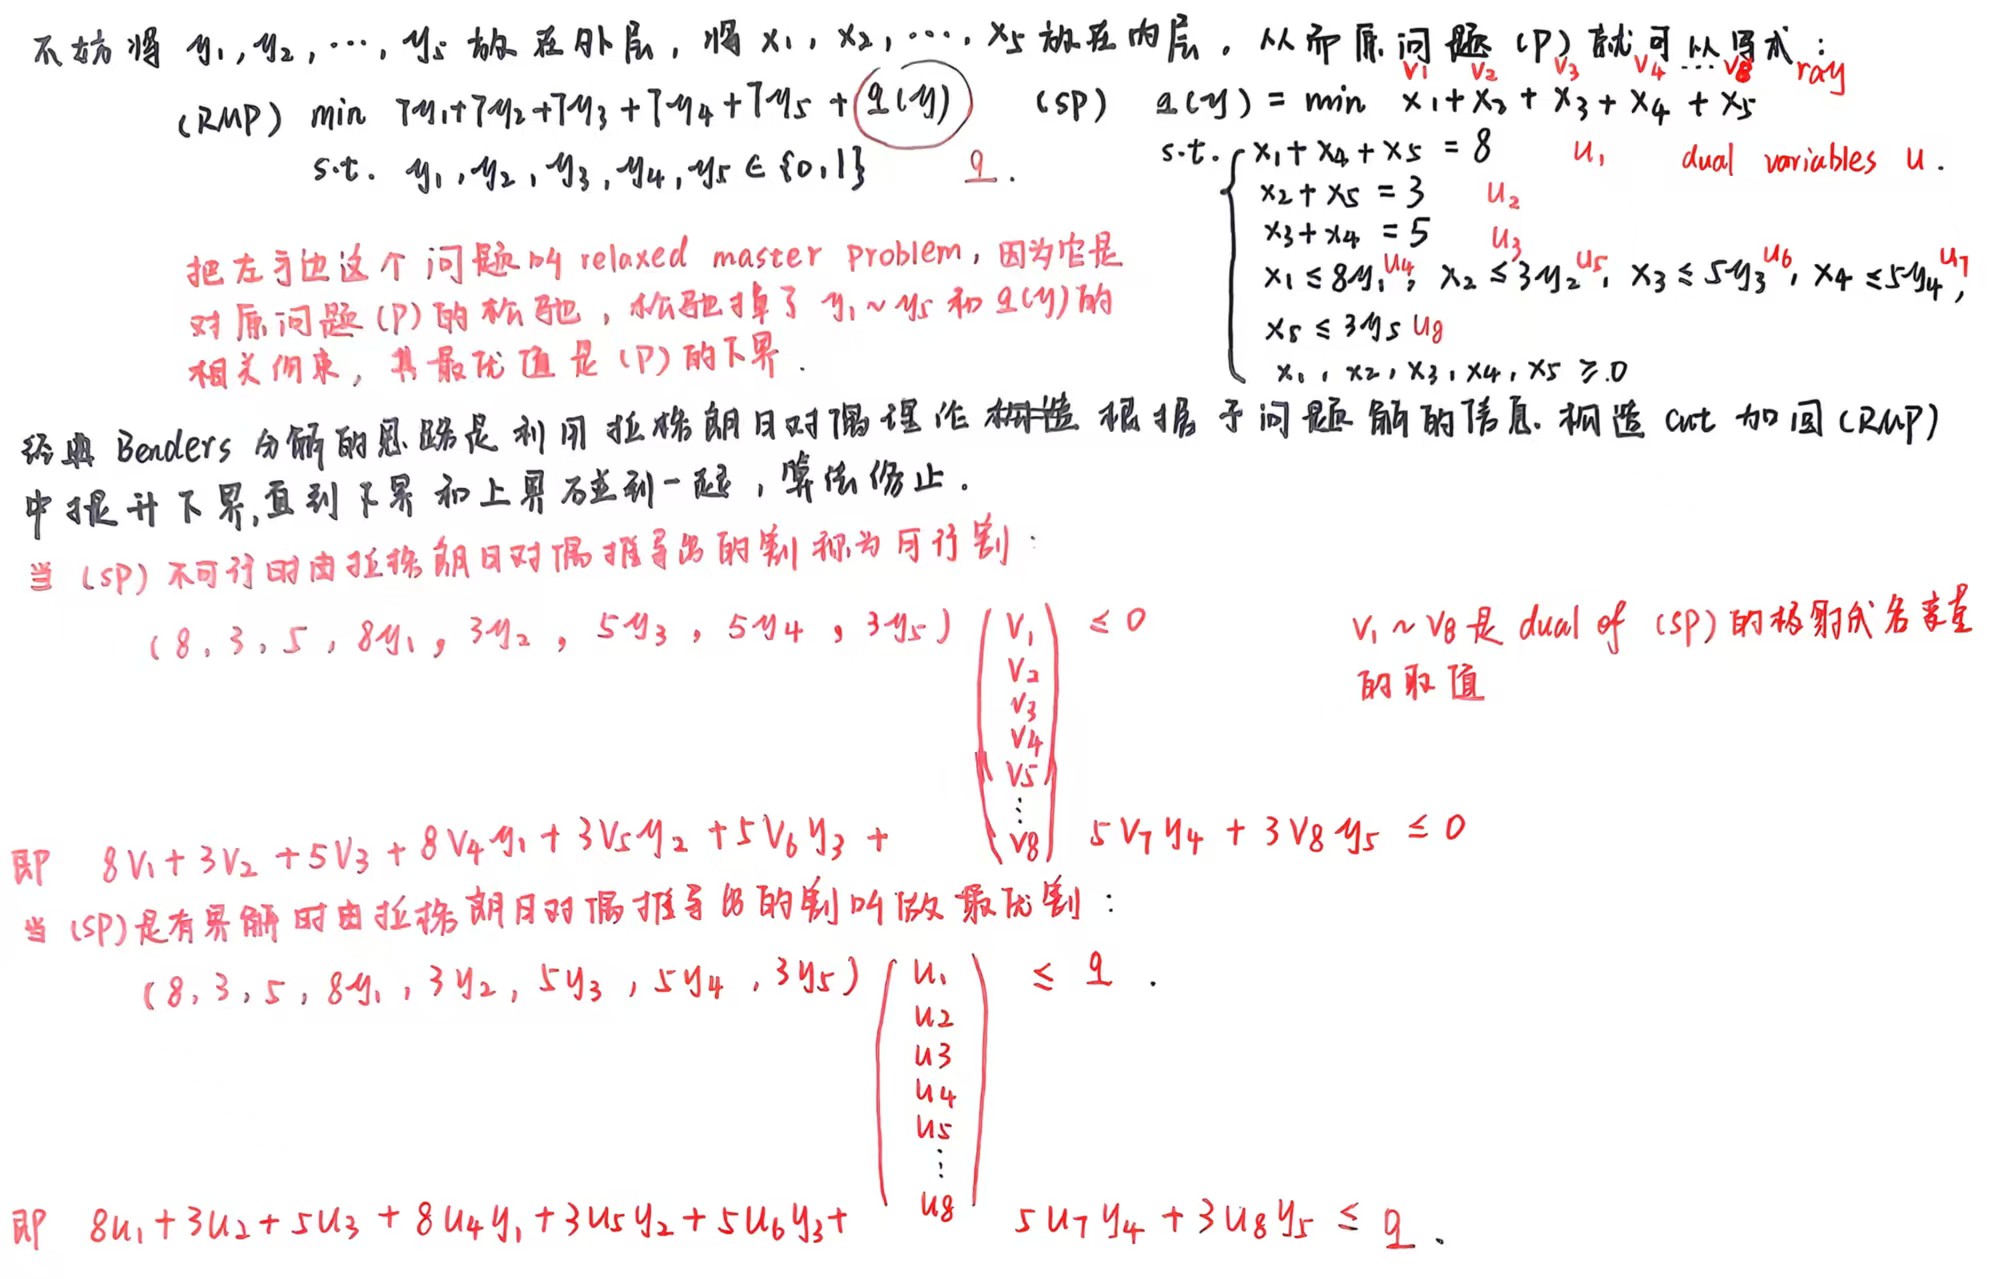
经典benders分解的例子2#!/usr/bin/env python
# -*- coding: utf-8 -*-
# @Date    : 2026-03-05 17:05:11
# @Author  : syuansheng (Dalian Maritime University)

from gurobipy import Model,GRB

class ClassicBendersModel:
    def __init__(self):
        self.rmp_model = Model(name='RMP') # 松弛主问题
        self.sp_model = Model(name='SP') # 子问题模型
        self.rmp_model.Params.LogToConsole = 0
        self.sp_model.Params.LogToConsole = 0
        self.sp_model.Params.InfUnbdInfo = 1 # 不开这个无法获取Farkasdual!!!
        self.sp_model.Params.DualReductions = 0
        self.lb_his,self.ub_his = [],[] # 原问题P的上下界历史
        self._construct()

    def _construct(self):
        # 构造松弛主问题和子问题
        self.y = self.rmp_model.addVars(range(1,6),vtype=GRB.BINARY,name='y')
        self.q = self.rmp_model.addVar(vtype=GRB.CONTINUOUS,lb=0,name='q') # 显然可以观察出q的一个下界是0
        self.x = self.sp_model.addVars(range(1,6),lb=0,vtype=GRB.CONTINUOUS,name='x')
        self.rmp_model.setObjective(
            7*self.y[1]+7*self.y[2]+7*self.y[3]+7*self.y[4]+7*self.y[5]+self.q
            ,sense=GRB.MINIMIZE
            )
        self.sp_model.setObjective(
            self.x.sum('*')
            ,sense=GRB.MINIMIZE
            )
        self.sp_model.addConstr(self.x[1]+self.x[4]+self.x[5]==8)
        self.sp_model.addConstr(self.x[2]+self.x[5]==3)
        self.sp_model.addConstr(self.x[3]+self.x[4]==5)
        self.sp_model.addConstr(self.x[1]<=8)
        self.sp_model.addConstr(self.x[2]<=3)
        self.sp_model.addConstr(self.x[3]<=5)
        self.sp_model.addConstr(self.x[4]<=5)
        self.sp_model.addConstr(self.x[5]<=3)
        self.sp_model.update()

    def _get_rmp_model_solution(self):
        # 读取松弛主问题的解和目标函数
        y,q,obj_rmp = [],None,self.rmp_model.ObjVal
        for var in self.rmp_model.getVars():
            if var.VarName.startswith('y'):
                y.append(var.X)
            elif var.VarName.startswith('q'):
                q = var.X
        return y,q,obj_rmp

    def _fix_sp_model(self,y):
        # 固定子问题
        self.sp_model.getConstrs()[3].RHS = 8*y[0]
        self.sp_model.getConstrs()[4].RHS = 3*y[1]
        self.sp_model.getConstrs()[5].RHS = 5*y[2]
        self.sp_model.getConstrs()[6].RHS = 5*y[3]
        self.sp_model.getConstrs()[7].RHS = 3*y[4]


    def run(self):
        lb,ub = -float('inf'),float('inf') # 原问题P的上下界
        while True:
            self.lb_his.append(lb) # 记录下界
            self.ub_his.append(ub) # 记录上界
            # 1. 求解松弛主问题
            self.rmp_model.optimize() # 求解限制主问题
            y,q,obj_rmp = self._get_rmp_model_solution() # 读取松弛主问题的解和目标函数
            lb = obj_rmp if obj_rmp>lb else lb # 更新下界
            # 2. 固定子问题,求解子问题
            self._fix_sp_model(y)
            self.sp_model.optimize()
            # 3. 根据子问题解的信息利用拉格朗日对偶理论生成割收紧松弛主问题的下界
            if self.sp_model.status == GRB.INFEASIBLE:
                v = self.sp_model.getAttr('FarkasDual',self.sp_model.getConstrs()) # 读取子问题对偶的极射线的反方向,也就是Farkas对偶值向量
                self.rmp_model.addConstr(
                    8*v[0]+3*v[1]+5*v[2]+8*v[3]*self.y[1]+3*v[4]*self.y[2]+5*v[5]*self.y[3]+5*v[6]*self.y[4]+3*v[7]*self.y[5]>=0,
                    name = 'feasible cut'
                    ) # 添加可行割
            elif self.sp_model.status == GRB.OPTIMAL:
                ub = obj_rmp-q+self.sp_model.ObjVal if (obj_rmp-q+self.sp_model.ObjVal)<ub else ub # 更新上界
                # 4. 终止条件(上界等于下界的推论是q==q(y))
                if abs(q-self.sp_model.ObjVal) <= 1e-3:
                    self.lb_his.append(lb) # 记录下界
                    self.ub_his.append(ub) # 记录上界
                    print("lb={},ub={},gap={}".format(lb,ub,(ub-lb)/ub))
                    break
                u = self.sp_model.getAttr('Pi',self.sp_model.getConstrs()) # 读取子问题对偶的极点
                self.rmp_model.addConstr(
                    8*u[0]+3*u[1]+5*u[2]+8*u[3]*self.y[1]+3*u[4]*self.y[2]+5*u[5]*self.y[3]+5*u[6]*self.y[4]+3*u[7]*self.y[5]<=self.q,
                    name = 'optimal cut'
                    ) # 添加最优割
            else:
                print('子问题的求解出现了异常现象')
            print("lb={},ub={},gap={}".format(lb,ub,(ub-lb)/ub))
        return self.lb_his,self.ub_his,obj_rmp,self.y,self.x

if __name__ == '__main__':
    model = ClassicBendersModel()
    lb_his,ub_his,obj_rmp,y,x=model.run()
    print("下界历史:{}".format(lb_his))
    print("上界历史:{}".format(ub_his))
    print("最优解y={},x={},最优值={}".format(y,x,obj_rmp))

# 输出结果
# lb=0.0,ub=inf,gap=nan
# lb=7.0,ub=inf,gap=nan
# lb=14.0,ub=inf,gap=nan
# lb=14.0,ub=22.0,gap=0.36363636363636365
# lb=22.0,ub=22.0,gap=0.0
# 下界历史:[-inf, 0.0, 7.0, 14.0, 14.0, 22.0]
# 上界历史:[inf, inf, inf, inf, 22.0, 22.0]
# 最优解y={1: <gurobi.Var y[1] (value 0.0)>, 2: <gurobi.Var y[2] (value 0.0)>, 3: <gurobi.Var y[3] (value 0.0)>, 4: <gurobi.Var y[4] (value 1.0)>, 5: <gurobi.Var y[5] (value 1.0)>},x={1: <gurobi.Var x[1] (value 0.0)>, 2: <gurobi.Var x[2] (value 0.0)>, 3: <gurobi.Var x[3] (value 0.0)>, 4: <gurobi.Var x[4] (value 5.0)>, 5: <gurobi.Var x[5] (value 3.0)>},最优值=22.0
注意如果模型不可行想要获取FarksDual或者模型无解想要获取极射线前必须设置InfUnbdInfo参数为1,打开不可行或误解信息日志,并将DualReductions参数设置为0,关闭对偶缩减
基于逻辑的Benders分解
Inference Dual
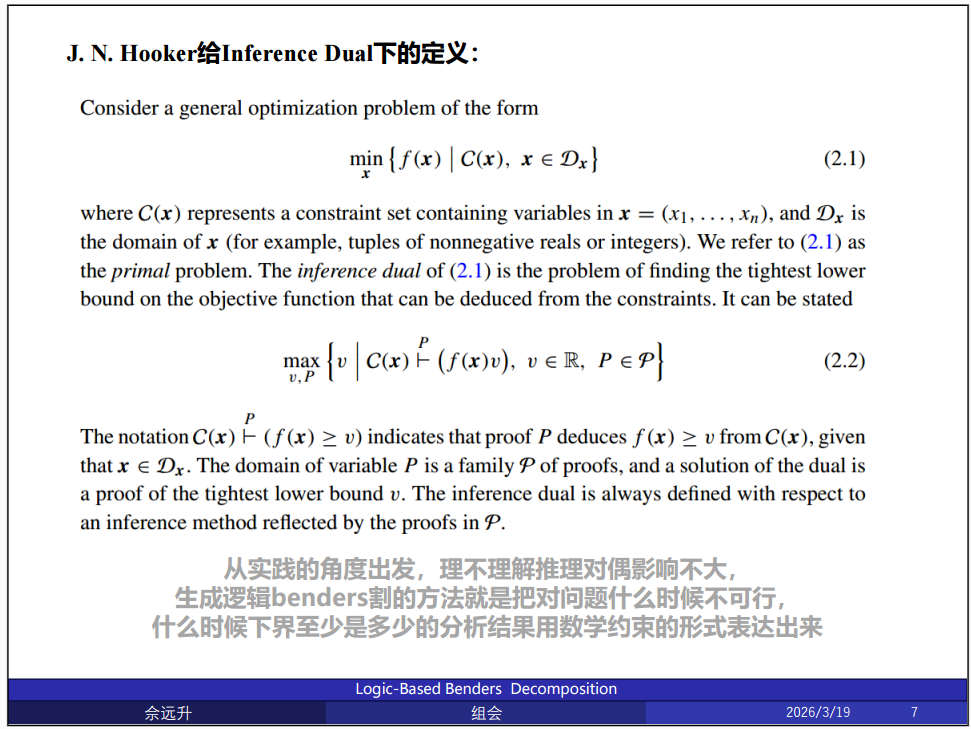
推理对偶的解非常抽象,在hooker给的定义中,推理对偶解是一个证明,这个解可以是任何形式,它甚至可以是一段话,比方说“如果x1=x2=1,那么原问题一定无解”,或者说“如果x1+x2=0,那么原问题的最优解目标函数值至少是5”。那这样的结论或者说是证明又是从哪来的呢?来自我们对问题的推理和分析过程,所以你去分析这个问题什么情况会不可行,或者什么情况,下界至少是某个值的这个逻辑推理过程就是在求解这个问题的推理对偶,而你的分析结果就是推理对偶的解。我们再把这样的分析结果,也就是推理对偶的解翻译成约束条件就可以得到逻辑benders可行割或者是最优割了。从实践的角度出发,理不理解推理对偶影响不大,生成逻辑benders割的方法就是把对问题什么时候不可行,什么时候下界至少是多少的分析结果用数学约束的形式表达出来。
LBBD割的设计
Benders割的分类
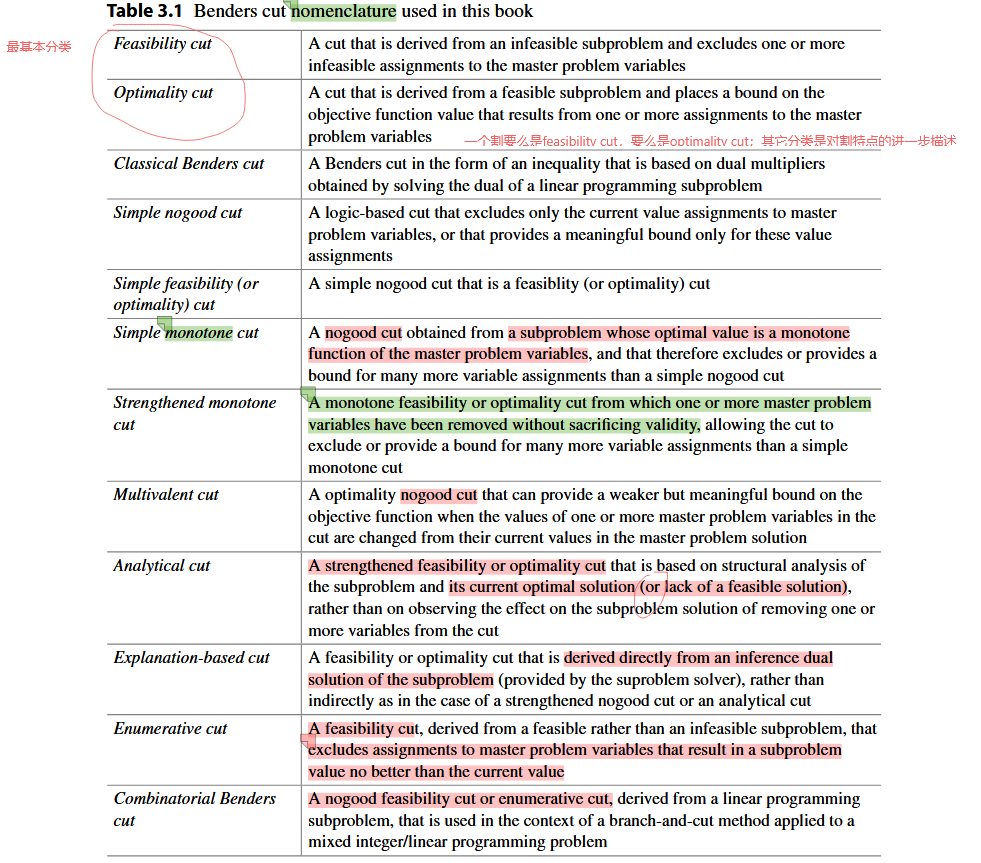
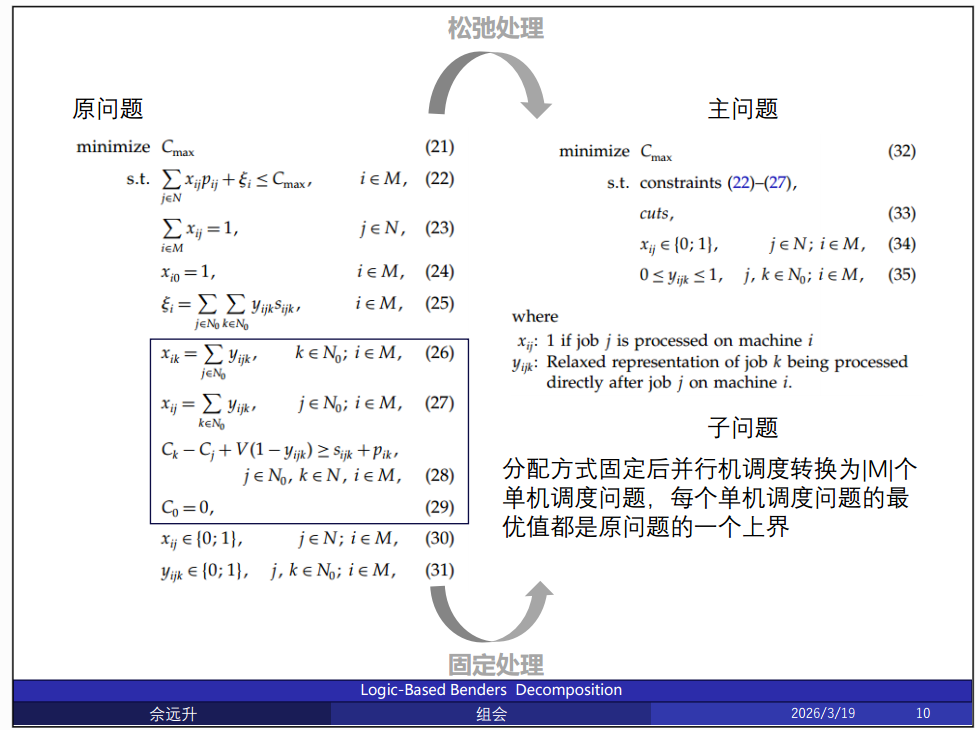
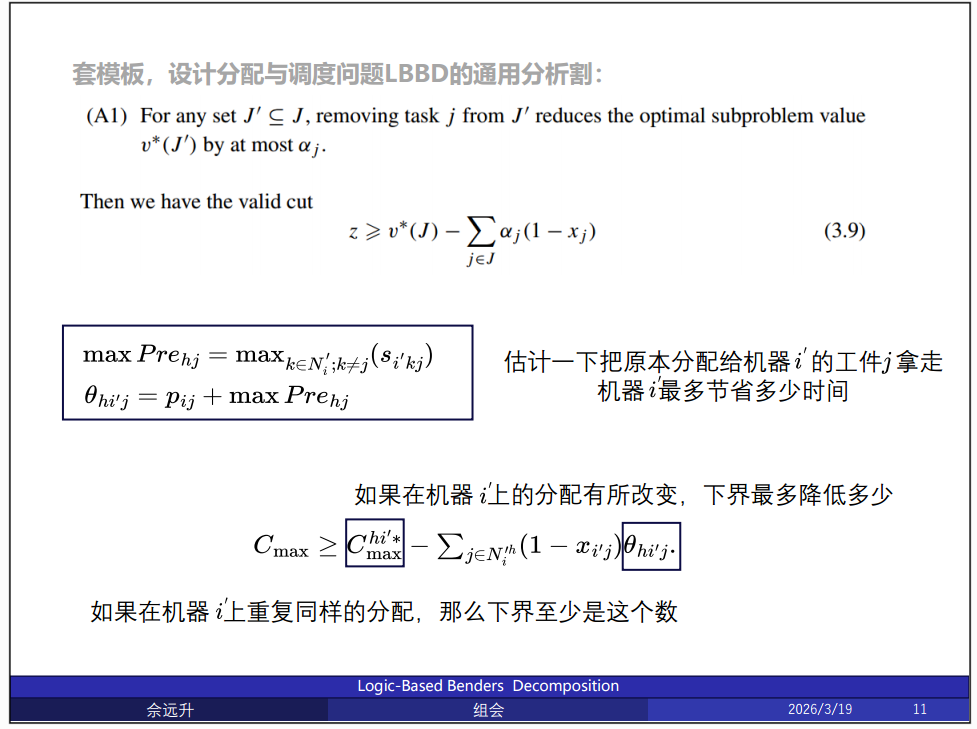
实战PMSP
求解器from gurobipy import Model,GRB,quicksum
from dataloader import DataLoaderPMSP

class GurobiForPMSP(DataLoaderPMSP):
    def __init__(self,src):
        # 初始化数据
        super(GurobiForPMSP,self)._parse(src)
        super(GurobiForPMSP,self)._consoleOutput()
        # 模型对象管理
        self.model = Model(name='PMSP')
        # 变量和辅助变量管理
        self.cmax = self.model.addVar(lb=0,ub=float('inf'),vtype=GRB.INTEGER,name='cmax') # 完工期
        self.xi = self.model.addVars(self.machine_set,lb=0,ub=float('inf'),vtype=GRB.INTEGER,name='xi') # 机器i的总准备时间
        self.x = self.model.addVars([(i,j) for i in self.machine_set for j in self.job_set_with_dummpy],vtype=GRB.BINARY,name='x') # 工件的分配
        self.y = self.model.addVars([(i,j,k) for i in self.machine_set for j in self.job_set_with_dummpy\
         for k in self.job_set_with_dummpy],vtype=GRB.BINARY,name='y') # 工件排序
        self.cjob = self.model.addVars([j for j in self.job_set_with_dummpy],lb=0,ub=float('inf'),vtype=GRB.INTEGER,name='cjob') # 某个工件完工时间

    def buildModel(self):
        # 搭建模型
        self.model.setObjective(
            self.cmax,
            sense = GRB.MINIMIZE
            )
        # (22)
        self.model.addConstrs(
            (quicksum(self.x[i,j]*self.pdict[i,j] for j in self.job_set_without_dummpy)+self.xi[i]<=self.cmax for i in self.machine_set),
            name = '每个机器的完工时间是总完工时间的下界'
            )
        # (23)
        self.model.addConstrs(
            (self.x.sum('*',j)==1 for j in self.job_set_without_dummpy),
            name = '每个工件都必须分配到一个机器上去'
            )
        # (24)
        self.model.addConstrs(
            (self.x[i,0]==1 for i in self.machine_set),
            name = '虚拟工件要分配到每一个机器上去'
            )
        # (25)
        self.model.addConstrs(
            (self.xi[i]==quicksum(self.y[i,j,k]*self.sdict[i,j,k] for j in self.job_set_with_dummpy for k in self.job_set_with_dummpy) for i in self.machine_set),
            name = '机器的等待时间计算'
            )
        # (26)
        self.model.addConstrs(
            (self.x[i,k]==quicksum(self.y[i,j,k] for j in self.job_set_with_dummpy) for k in self.job_set_with_dummpy for i in self.machine_set),
            name = '排序约束1'
            )
        # (27)
        self.model.addConstrs(
            (self.x[i,j]==quicksum(self.y[i,j,k] for k in self.job_set_with_dummpy) for j in self.job_set_with_dummpy for i in self.machine_set),
            name = '排序约束2'
            )
        # (28)
        self.model.addConstrs(
            (self.cjob[k]-self.cjob[j]+999*(1-self.y[i,j,k])>=self.sdict[i,j,k]+self.pdict[i,k] for j in self.job_set_with_dummpy for k in self.job_set_without_dummpy for i in self.machine_set),
            name = '工件完工时间连续性约束'
            )
        # (28') 这个约束可加可不加,不加不影响cmax计算,但是cjob算出来会有问题
        self.model.addConstrs(
            (self.cjob[j]<=self.cmax for j in self.job_set_without_dummpy)
            )
        # (29)
        self.model.addConstr(
            self.cjob[0] == 0,
            name = '虚拟工件完工时间计算'
            )
    def runModel(self):
        # 设置Parameter,控制求解器的行为,然后运行求解器
        self.model.optimize()

    def outputFile(self):
        self.model.write('GurobiForPMSPmodel.lp')
        self.model.write('GurobiForPMSPsolution.sol')

if __name__ == '__main__':
    pmspmodel = GurobiForPMSP('./dataM3N12.xlsx')
    pmspmodel.buildModel()
    pmspmodel.runModel()
    pmspmodel.outputFile()
lbbd实现——基于通用割的实现#!/usr/bin/env python
# -*- coding: utf-8 -*-
# @Date    : 2026-03-09 14:20:05
# @Author  : syuansheng (Dalian Maritime University)

import sys
sys.path.append('D:/code repository/项目')
from numpy import zeros
from gurobipy import Model,GRB,quicksum
from easylbbdf.lbbdframework import *
from dataloader import DataLoaderPMSP
from time import time

"""
mp是主问题模型,subp是某个子问题模型,subps是所有子问题模型
"""
# 1. 创建主问题模型和子问题模型
## 1.1 读取算例涉及的集合和参数
dataloader = DataLoaderPMSP()
dataloader._parse('./dataM3N12.xlsx')
dataloader._consoleOutput()
## 1.2 创建主问题模型
mp_model = Model("MainProblme")
mp_model.Params.LogToConsole = 0
cmax = mp_model.addVar(lb=0,ub=float('inf'),vtype=GRB.INTEGER,name='cmax') # 完工期
xi = mp_model.addVars(dataloader.machine_set,lb=0,ub=float('inf'),vtype=GRB.INTEGER,name='xi') # 机器i的总准备时间
x = mp_model.addVars([(i,j) for i in dataloader.machine_set for j in dataloader.job_set_with_dummpy],vtype=GRB.BINARY,name='x') # 工件的分配
y = mp_model.addVars([(i,j,k) for i in dataloader.machine_set for j in dataloader.job_set_with_dummpy\
         for k in dataloader.job_set_with_dummpy],lb=0,ub=1,vtype=GRB.CONTINUOUS,name='y') # 工件排序,松弛掉了
mp_model.setObjective(cmax,sense=GRB.MINIMIZE)
mp_model.addConstrs(
    (quicksum(x[i,j]*dataloader.pdict[i,j] for j in dataloader.job_set_without_dummpy)+xi[i]<=cmax for i in dataloader.machine_set),
    name = '完工期下界计算'
    )
mp_model.addConstrs(
    (x.sum('*',j)==1 for j in dataloader.job_set_without_dummpy)
    ,name = '工件分配1'
    )
mp_model.addConstrs(
    (x[i,0]==1 for i in dataloader.machine_set),
    name = '工件分配2'
    )
mp_model.addConstrs(
    (xi[i]==quicksum(y[i,j,k]*dataloader.sdict[i,j,k] for j in dataloader.job_set_with_dummpy for k in dataloader.job_set_with_dummpy) for i in dataloader.machine_set),
    name = '机器的等待时间计算'
    )
mp_model.addConstrs(
    (x[i,k]==y.sum(i,"*",k) for k in dataloader.job_set_with_dummpy for i in dataloader.machine_set),
    name = '排序约束组(松弛)1'
    )
mp_model.addConstrs(
    (x[i,j]==y.sum(i,j,"*") for j in dataloader.job_set_with_dummpy for i in dataloader.machine_set),
    name = '排序约束组(松弛)2'
    )

## 1.3 创建子问题模型,每个子问题都是一个旅行商问题
subps = [Model('subp{}'.format(i)) for i in range(dataloader.machin_num)]
for subp in subps:
    subp.Params.LogToConsole = 0

# 2.创建工具箱,添加solveMP、addMPFeasibleCut、addMPOptimalCut、fixSubPs和sovleSubPs方法
def solveMp(mp):
    mp.optimize()
    return mp.ObjVal

def addMPFeasibleCut(mp,subp):
    # 这个问题的子问题始终是可行的,不用管可行割
    pass

def addMPOptimalCut(mp,subp):
    machine_index = int(subp.ModelName[4:])+1 # 当前子问题对应的机器
    job2thissubp = [] # 主问题分配给这个子问题的工件的集合
    for var in mp.getVars():
        if var.VarName.startswith('x') and var.VarName[1:].startswith('['):
            i,j = list(map(int,var.VarName[2:-1].split(',')))
            if i == machine_index and var.X > 0.99:
                job2thissubp.append(j)
    theta = {key:None for key in job2thissubp} # 将分配给当前机器的某个工件移除,对应子问题的最优值最多下降多少
    for job in theta.keys():
        maxpre_time = 0
        for another_job in theta.keys():
            if dataloader.sdict[machine_index,another_job,job] > maxpre_time:
                maxpre_time = dataloader.sdict[machine_index,another_job,job]
        if job != 0 :
            theta[job] = maxpre_time+dataloader.pdict[machine_index,job]
        else:
            theta[job] = 0
    ## 这个加上之后效果好了很多
    beta = {key:None for key in range(dataloader.job_num+1) if key not in job2thissubp} # 将其他工件忘这个机器放最优值至少增加多少
    for job in beta.keys():
        minpre_time = float('inf')
        for another_job in range(dataloader.job_num+1):
            if dataloader.sdict[machine_index,another_job,job] < minpre_time:
                minpre_time = dataloader.sdict[machine_index,another_job,job]
        beta[job] = minpre_time+dataloader.pdict[machine_index,job]
    subp_obj = subp.ObjVal #当前子问题最优值
    mp.addConstr(
        cmax>=subp_obj-quicksum(theta[j]*(1-x[machine_index,j]) for j in job2thissubp)\
        +quicksum(beta[j]*x[machine_index,j] for j in beta.keys()),
        name = '最优割'
        )

def fixSubPs(mp,subps):
    # 获取主问题的分配情况
    jobs2machine = [[] for _ in range(dataloader.machin_num)] # 元素是列表,第一个元素表示分配给第一个机器的工件集合,以此类推
    for var in mp.getVars():
        if var.VarName.startswith('x') and var.VarName[1:].startswith('['):
            i,j = list(map(int,var.VarName[2:-1].split(',')))
            if var.X > 0.9:
                jobs2machine[i-1].append(j)
    # 根据主问题的解固定子问题
    for i,subp in enumerate(subps):
        job2thissubp = jobs2machine[i] # 改子问题对应机器分配到的工件的集合
        # 每个子问题都是一个TSP,包含的节点就是分配给它的那些工件
        y = subp.addVars([j for j in job2thissubp],[k for k in job2thissubp],vtype=GRB.BINARY,name='y')
        cjob = subp.addVars([j for j in job2thissubp],lb=0,ub=float('inf'),vtype=GRB.INTEGER,name='cjob')
        subp.setObjective(
            sum(dataloader.pdict[i+1,j] for j in job2thissubp if j!=0)+\
            quicksum(y[j,k]*dataloader.sdict[i+1,j,k] for j in job2thissubp for k in job2thissubp),
            sense = GRB.MINIMIZE
            )
        subp.addConstrs(
            (1==y.sum(j,"*") for j in job2thissubp)
            ,name = '每个点都有一个出边'
            )
        subp.addConstrs(
            (1==y.sum("*",k) for k in job2thissubp),
            name = '每个点都有一个入边'
            )
        subp.addConstr(cjob[0]==0,name='子回路消除1')
        subp.addConstrs(
            (cjob[j]+dataloader.sdict[i+1,j,k]+dataloader.pdict[i+1,k]-cjob[k]<=600*(1-y[j,k]) for k in [k for k in job2thissubp if k!=0] for j in job2thissubp),
            name = '子回路消除2'
            ) # M的取值影响蛮大的,这里的M是任意两个工件完工时间之间的最大差值,假设所有工件都在一台机器上加工

def solveSubPs(subps):
    # 这里偷个懒,TSP还是直接用求解器求解
    for subp in subps:
        subp.optimize()

toolbox = ToolBox()
toolbox.register("solveMP",solveMp)
toolbox.register("addMPFeasibleCut",addMPFeasibleCut)
toolbox.register("addMPOptimalCut",addMPOptimalCut)
toolbox.register("fixSubPs",fixSubPs)
toolbox.register("solveSubPs",solveSubPs)

# 3. 调用框架进行求解
lbbdmodel = LogicBasedBendersDecompositionModel(mp_model,subps,toolbox,max_time=60,max_iter=200)
lbbdmodel.runModel()
print(lbbdmodel.lb_his)
print(lbbdmodel.ub_his)
lbbdmodel.mp.write('mp_model_last.lp')
用LBBD的论文是怎么写的
参考论文:Joint berth allocation and ship loader scheduling under the rotary loading mode in coal export terminals
作者:Zhen Cao , Wenyuan Wang , Ying Jiang , Xinglu Xu , Yunzhuo Xu , Zijian Guo
- 主问题增强Master problem enhancements(MPEs)
- 介绍子问题生成的可行割和最优割并证明其有效性
- 设计benders割增强启发式,这个设计思路就是将当前割缩紧成不可约割,参考Logic-Based Benders Decomposition Theory and Applications上给出的greedy procedure和deletion filter,前者不保证把割转换为不可约割后者一定保证把割转换为不可约割,但是所需迭代次数会更多
- 证明算法能够在有限步收敛到最优解
参考论文:An exact algorithm for integrated planning of operations in dry bulk terminals
作者:Ozgur Unsal, Ceyda Oguz
- 主问题增强Master problem enhancements(MPEs)
- 分析不可行性产生的具体原因,提出可行性割,证明有效性
参考论文:Integrated optimization of multi-machine scheduling and berth allocation in automated ore terminals
作者:Zhendi Gao, Mingjun Ji , Lingrui Kong
- 主问题增强Master problem enhancements(MPEs),他这个增强有点扯,不是给主问题加约束映入子问题因素,而是加目标函数
- 提出可行割割证明有效性
参考资料
- 张树柱主讲运筹优化系列课程
- 整数规划的拉格朗日松弛(理论分析+Python代码实现)
- 拉格朗日松弛求解整数规划浅析
- 列生成算法教程集锦
- 从集合划分问题到列生成算法
- 从零开始的列生成算法(Column Generation)原理及案例
- 并行机调度问题遗传算法
- 经典benders分解
- benders分解——张树栋
- Benders Day - John Hooker - Logic-Based Benders Decomposition
- John Hooker’s Available Presentations
- LBBD for PMS——张树栋
- 基于Gurobi 的列生成和 Benders 分解方法
- Logic-based Benders分解学习笔记(一)
- John Hooker, Logic-Based Benders Decomposition: Theory and Applications
 微信


