
带资源约束的MCNFP问题求解
什么是带资源约束的MCNFP问题
我现在手上有几类商品,每类商品都有已知的起点和终点以及运输量。我需要做的是借助一个结构确定但每个运输路段都有容量限制和成本属性的运输网络把各类商品从起点运到终点,使得总的成本尽可能小,这就是著名的多商品网络流问题(MCNFP)。带资源约束的MCNFP问题进一步考虑商品在沿着路径运输的时候会消耗某种资源,要求这一资源的消耗量不超过给定值。 MCNFP和带资源约束的MCNFP都是NP-hard问题,但是后者会更难一些。如果把问题拆分为主问题、子问题的结构,那MCNFP的子问题是最短路问题SPP,而带资源约束的MCNFO的子问题会是资源限制最短路问题RCSSP。
这blog的余下内容复现了A Multicommodity Network-Flow Problem with Side Constraints on Paths Solved by Column Generation这篇论文。这篇文章很古老了,是2003年的,所以整体来说技术难度不是很大,但我觉得还是很有价值的:
- 通过这篇论文入门了RCSSP的基础精确解法——标签算法。
- 巩固了问题拆分为主、子问题使用列生成算法求解的基本套路。
- 一般来说CG主问题会构造成集划分/包裹/覆盖问题,这篇文章主问题直接就是一个LP。打破固有思维,主问题形式不一定固定,那整体套路是什么?
MILP模型及其重构
| 符号 | 含义 | 说明 |
|---|---|---|
| 节点集合 | 网络 |
|
| 弧集合 | 有向弧 | |
| 商品集合 | ||
| 商品下标 | ||
| 商品 |
origin | |
| 商品 |
destination(注意与需求 |
|
| 商品 |
从 |
|
| 弧下标 | ||
| 弧 |
假设 |
|
| 商品 |
假设 |
|
| 商品 |
假设 |
|
| 商品 |
路径侧约束 bound | |
| 路径下标 | 无环的弧链 | |
| 路径构成的集合 | ||
| indicator parameter | 指定路径 |
|
| 路径 |
||
| 弧-路径关联 | ||
| 路径 |
连续, |
|
| 路径 |
注意:Colossus框架目前不支持方案集合分组操作,写代码的时候咱们需要使用整体方案集
以及indicator parameter 来表征路径信息 是不是属于商品 的。而不是直接使用分组后的方案集 。所以这块儿的符号体系用的和原文不一样。
下面是带资源约束MCNFP问题的MILP模型,和MCNFP模型区别就在于多了约束(4)。
约束(1)确保各个商品的运输任务都得到满足;约束(2)确保每个弧的容量不超;约束(3)是一个大M约束,表达if-then逻辑关系”如果我没有选择路径r,那么路径r上不应该有流量”。怎么把这个问题拆解成主子问题结构用CG去求解呢?结合俺之前做的研究,我觉得套路是:
- 针对单一对象或多对象组合定义方案,使得主问题在已知所有方案的前提下即等价或近似等价于MILP模型。
- 方案就是子问题要决策的东西,尽量不要让子问题太复杂,设计方案的时候就要考虑到。最好让子问题呈现出特殊结构。
- 子问题按照对象或多对象组合进行分解(取决于你主问题咋建的,如果主问题是按单一对象定义方案,子问题就按单一对象分解,如果是按多对象组合定义方案,就按相应多对象组合分解),这里可以分解的原因在于你把对应的耦合约束全部放主问题里面了。子问题负责生成对象或对象组合对应的方案,只需要考虑单一对象或对象组合下方案合法性的相关约束即可。
关于模型重构的思路
另一种关于模型重构我觉得比较合理的思路是:把复杂约束全部隐藏到集合的构造阶段,对应到列生成的场景,子问题就是构造这样的集合的问题。
比较抽象?对应这篇文章研究的问题:
- 我们把商品作为对象,这个对象要完成的事情是从起点经由容量限制的网络运输到终点。这件事儿就等价于说我选择哪些起点到终点的路径,以什么流量运输对吧?所以一种很直白的方案定义是——方案=路径信息+路径上的流量。那这种定义好不好呢?咱们想一想。用这个方案定义的话主问题决策变量就是方案选择变量了,主问题模型建立出来应该是一个0-1规划问题。子问题的决策变量就会是路径构成+路径流量,写完子问题是没啥特殊结构的。当然大概率也是可以硬解的啦,但显然这种方案定义不太好。
- 这篇文章是咋定义方案的呢?我子问题不要做太多的决策,就搞路径构成问题就行了,这里的路径构成指的是对应指定商品找到从起点到终点的最短路(考虑资源限制),也就是RCSSP问题(虽然还是NP-Hard),但是是有伪多项式时间精确求解算法的。所以方案定义成路径信息是不错的,至少子问题简单。运气更好的是,这种方案定义下,主问题的决策变量会是路径流量,主问题模型就会是LP模型。CG可以实现精确求解!
从这篇文章可以看到把问题拆分成主问题、子问题用列生成求解的时候方案定义是非常重要的事情,好的方案定义可以使得主问题和子问题的求解都比较简单。方案定义好,主问题和子问题建模就好写了:
假设约束组(1)对应的对偶是
对于商品k的子问题,就是负责生成路径信息
子问题本身就是要生成方案,所以主问题的方案索引
不再作为索引,且子问题明确是针对商品 的所以 也不再充当索引作用
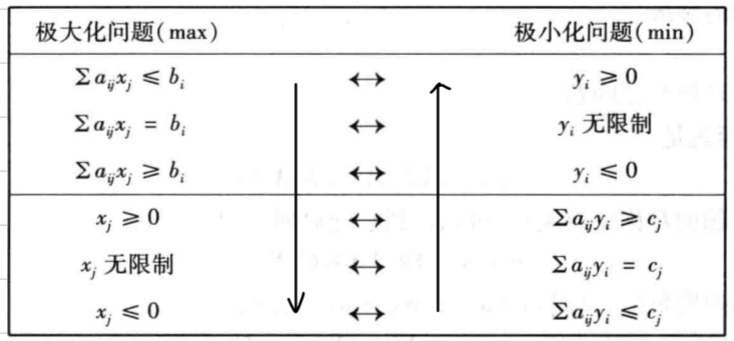 线性规划对偶的对应关系
根据线性规划对偶的对应关系,我们知道
显然这个模型的最优解和下面这个模型的最优解是一样的,也就是说子问题的最优解可以通过求解下面这个RCSPP的最优解得到。最优值只需再减去一个
列生成算法求解
代码基于作者开发的Colossus框架实现,暂无开源计划
初始列构造
我们当然可以找到MILP问题的一组可行解,转换为初始可行列。但为了方便求解,这里和作者一样偷个懒,映入人工变量
正常情况下应该叫构造初始可行列,这里偷懒就构造初始列。人工变量可以保证即使构造的初始列之间不兼容,主问题也始终是有解的。 不建议自己做研究这么搞,会让人觉得很没水平~~~
此时不需要保证初始列在主问题中是兼容的,那我们在子问题k中直接用
#!/usr/bin/env python
# -*- coding: utf-8 -*-
# @Author  : syuansheng (Dalian Maritime University)

"""
定义生成初始列池的方法
"""
import sys
sys.path.append('../../../')
from Colossus import Column,ColumnPool
from Colossus.common_exact_method import label_setting_method

def _check(a,best_path):
  flag = False # a在路径里面取True,否则取False
  for _a in zip(best_path[:-1],best_path[1:]):
    if a==_a:
      flag = True
      break
  return flag

def generateInitialCols(C,A,stnode_dict,l_dict,adjacency_list_dict):
  """
  Args:
    C: 商品集合
    A:网络弧集合
    stnode_dict:各个商品起点和终点集合
    l_dict:各个商品路径资源上限
    adjacency_list_dict:各个商品对应的网络的邻接矩阵
  Returns:
    columnpool:包含初始列的列池
  """
  columnpool = ColumnPool()
  for k in C:
    # 解与子问题最优解等价的RCSPP问题构造初始列
    best_obj,best_path=label_setting_method(adjacency_list_dict[k],stnode_dict[k][0],stnode_dict[k][1],resource_ub=l_dict[k])
    column = Column()
    column.omega = k
    column.tau = best_obj
    column.coefficients = [] # 列系数的长度应该是|C|+|A|
    for _k in C:
      if _k==k:
        column.coefficients.append(1)
      else:
        column.coefficients.append(0)
    for a in A:
      # 检查a是否包含在best_path里面,是的话系数取1否则取0
      if _check(a,best_path):
        column.coefficients.append(1)
      else:
        column.coefficients.append(0)
    columnpool.addCol(column)
  return columnpool
定义限制主问题
#!/usr/bin/env python
# -*- coding: utf-8 -*-
# @Author  : syuansheng (Dalian Maritime University)

"""
定义限制主问题的数学模型
"""
from gurobipy import Model,GRB,quicksum

def buildRestrictedMP(columnpool,d_dict,A,u_dict):
  R_restricted = [r for r in range(1,columnpool.col_num+1)]
  C = [k for k in range(1,columnpool.col_num+1)]
  model = Model()
  h = model.addVars(R_restricted,vtype=GRB.CONTINUOUS,name='h')
  s = model.addVars(C,vtype=GRB.CONTINUOUS,name='s')
  model.setObjective(
    quicksum(columnpool[r].tau*h[r] for r in R_restricted)+quicksum(99999*s[k] for k in C)
    ,sense = GRB.MINIMIZE
    )
  theta = {}
  for r in R_restricted:
    for k in C:
      theta[r,k]=columnpool[r].coefficients[k-1]
  model.addConstrs(
    (quicksum(theta[r,k]*h[r] for r in R_restricted)+s[k]==d_dict[k] for k in C)
    ,name = 'Constrs1'
    )
  delta = {}
  for r in R_restricted:
    for idx,a in enumerate(A,start=0):
      delta[r,a] = columnpool[r].coefficients[columnpool.col_num:][idx]
  model.addConstrs(
    (quicksum(delta[r,a]*h[r] for r in R_restricted)<=u_dict[a] for a in A)
    ,name = 'Constrs2'
    )
  return model
定义子问题精确求解的办法
踩坑总结:子问题构造的新列在主问题目标函数中的取值
是基于子问题对应的那个网络(弧成本是 )算的,不是通过和子问题最优解等价对应的那个网络(弧成本是 )计算的!!!
#!/usr/bin/env python
# -*- coding: utf-8 -*-
# @Author  : syuansheng (Dalian Maritime University)

"""
定义如何精确求解定价子问题
"""

import sys
sys.path.append('../../../')
from Colossus import Column
from Colossus.common_exact_method import label_setting_method


def _check(a,best_path):
  flag = False # a在路径里面取True,否则取False
  for _a in zip(best_path[:-1],best_path[1:]):
    if a==_a:
      flag = True
      break
  return flag

def updateAndSolveSP_Exact(y,fingerprint,omega_next_col,C,A,arcs_info,stnode_dict,l_dict):
  improve_column_lst = []
  # 对偶变量分组
  v = y[:len(C)]
  pi = y[len(C):len(C)+len(A)]
  # 通过arcs_info把当前要求解的fingerprint(取k)对应的子问题的图构造成label_setting_method的输入格式
  adjacency_list=[[] for _ in range(len(arcs_info))]
  for node1,node2,_,cost,weight in arcs_info:
    a_idx = A.index((node1,node2))
    adjacency_list[node1].append((node2,cost-pi[a_idx],weight))
  best_obj,best_path=label_setting_method(adjacency_list,stnode_dict[fingerprint][0],stnode_dict[fingerprint][1],resource_ub=l_dict[fingerprint])
  reduced_cost = best_obj-v[fingerprint-1]
  if reduced_cost < -1e-6:
    # 构造改善列
    column = Column()
    column.omega = omega_next_col
    column.coefficients = [] # 列系数的长度应该是|C|+|A|
    for _k in C:
      if _k==fingerprint:
        column.coefficients.append(1)
      else:
        column.coefficients.append(0)
    for a in A:
      # 检查a是否包含在best_path里面,是的话系数取1否则取0
      if _check(a,best_path):
        column.coefficients.append(1)
      else:
        column.coefficients.append(0)
    # 把c_r反推回来
    c_r = reduced_cost+v[fingerprint-1]+sum([pi[idx]*column.coefficients[len(C):][idx] for idx in range(len(pi))])
    column.tau=c_r
    improve_column_lst.append(column)
  return improve_column_lst
搭建工具箱、环境和求解引擎
#!/usr/bin/env python
# -*- coding: utf-8 -*-
# @Author  : syuansheng (Dalian Maritime University)

"""
复现论文:A Multicommodity Network-Flow Problem with Side Constraints on Paths Solved by Column Generation
"""

# 偷个懒,不妨假设成本和权重(资源消耗)只和弧有关系,和商品类型无关
# 小规模测试算例
# inst = {
#     "num_nodes": 5,
#     "arcs": [[0, 2, 6, 1, 1], [0, 4, 6, 3, 1], [1, 2, 6, 1, 1], [1, 4, 6, 3, 1], [2, 3, 8, 1, 1], [4, 3, 8, 3, 1]], # [起点, 终点, 容量, 成本, 权重]
#     "commodities": [[0, 3, 6, 10], [1, 3, 6, 10]], # [起点, 终点, 需求, 侧约束上限 bound]
# }
# 大规模算例
# inst = {
#     "name": "large_complete_15_k12",
#     "num_nodes": 15,    "arcs": [[0, 1, 4, 4, 10], [0, 2, 4, 17, 4], [0, 3, 10, 9, 5], [0, 4, 6, 10, 2], [0, 5, 4, 15, 5], [0, 6, 2, 15, 7], [0, 7, 3, 13, 2], [0, 8, 3, 9, 4],\
#     [0, 9, 7, 11, 6], [0, 10, 2, 9, 6], [0, 11, 3, 17, 3], [0, 12, 6, 6, 9], [0, 13, 5, 9, 3], [0, 14, 8, 1, 2], [1, 0, 8, 4, 10], [1, 2, 9, 11, 1], [1, 3, 3, 3, 5],\
#     [1, 4, 3, 7, 7], [1, 5, 7, 13, 10], [1, 6, 4, 15, 10], [1, 7, 3, 4, 2], [1, 8, 9, 19, 10], [1, 9, 10, 12, 3], [1, 10, 5, 4, 8], [1, 11, 6, 17, 4], [1, 12, 9, 9, 8],\
#     [1, 13, 5, 20, 4], [1, 14, 9, 16, 5], [2, 0, 6, 17, 5], [2, 1, 10, 4, 2], [2, 3, 6, 3, 5], [2, 4, 3, 9, 2], [2, 5, 3, 1, 3], [2, 6, 3, 14, 2], [2, 7, 6, 17, 10], [2, 8, 6, 3, 7],\
#     [2, 9, 3, 16, 3], [2, 10, 2, 18, 7], [2, 11, 4, 15, 5], [2, 12, 8, 16, 8], [2, 13, 3, 14, 7], [2, 14, 10, 20, 2], [3, 0, 3, 9, 8], [3, 1, 8, 13, 4], [3, 2, 9, 15, 10], [3, 4, 4, 16, 2],\
#     [3, 5, 10, 19, 3], [3, 6, 8, 16, 5], [3, 7, 9, 19, 8], [3, 8, 6, 1, 7], [3, 9, 9, 14, 1], [3, 10, 9, 12, 10], [3, 11, 8, 12, 8], [3, 12, 8, 9, 6], [3, 13, 3, 10, 9], [3, 14, 6, 7, 1],\
#     [4, 0, 9, 18, 8], [4, 1, 8, 9, 2], [4, 2, 5, 13, 2], [4, 3, 9, 2, 4], [4, 5, 9, 10, 1], [4, 6, 3, 1, 10], [4, 7, 4, 17, 5], [4, 8, 9, 17, 6], [4, 9, 6, 9, 2], [4, 10, 9, 2, 3], [4, 11, 2, 7, 1],\
#     [4, 12, 8, 8, 5], [4, 13, 8, 17, 5], [4, 14, 2, 6, 4], [5, 0, 7, 7, 10], [5, 1, 7, 11, 5], [5, 2, 9, 12, 1], [5, 3, 6, 18, 10], [5, 4, 7, 6, 9], [5, 6, 6, 7, 6], [5, 7, 10, 16, 7], [5, 8, 5, 8, 7],\
#     [5, 9, 2, 18, 9], [5, 10, 10, 11, 8], [5, 11, 9, 20, 1], [5, 12, 6, 8, 7], [5, 13, 3, 16, 6], [5, 14, 8, 3, 5], [6, 0, 3, 4, 3], [6, 1, 2, 7, 1], [6, 2, 5, 5, 4], [6, 3, 6, 9, 8], [6, 4, 2, 15, 3],\
#     [6, 5, 2, 18, 7], [6, 7, 10, 2, 2], [6, 8, 6, 9, 6], [6, 9, 10, 18, 7], [6, 10, 7, 14, 3], [6, 11, 6, 15, 4], [6, 12, 3, 3, 3], [6, 13, 2, 6, 3], [6, 14, 4, 1, 4], [7, 0, 5, 12, 10], [7, 1, 2, 18, 1],\
#     [7, 2, 5, 19, 7], [7, 3, 6, 15, 5], [7, 4, 10, 16, 6], [7, 5, 6, 3, 6], [7, 6, 4, 2, 9], [7, 8, 5, 4, 2], [7, 9, 5, 14, 2], [7, 10, 7, 2, 3], [7, 11, 6, 3, 1], [7, 12, 7, 10, 1], [7, 13, 2, 5, 7],\
#     [7, 14, 10, 19, 3], [8, 0, 4, 1, 8], [8, 1, 10, 15, 8], [8, 2, 5, 17, 1], [8, 3, 7, 10, 2], [8, 4, 9, 9, 4], [8, 5, 8, 10, 10], [8, 6, 5, 17, 1], [8, 7, 8, 18, 4], [8, 9, 10, 1, 6], [8, 10, 10, 4, 2],\
#     [8, 11, 7, 13, 7], [8, 12, 9, 15, 5], [8, 13, 2, 12, 6], [8, 14, 5, 1, 5], [9, 0, 8, 5, 5], [9, 1, 9, 19, 5], [9, 2, 7, 7, 9], [9, 3, 3, 19, 8], [9, 4, 6, 1, 2], [9, 5, 3, 15, 6], [9, 6, 4, 19, 7],\
#     [9, 7, 5, 20, 7], [9, 8, 2, 9, 7], [9, 10, 4, 7, 1], [9, 11, 5, 13, 8], [9, 12, 6, 8, 7], [9, 13, 9, 17, 2], [9, 14, 9, 8, 4], [10, 0, 4, 7, 5], [10, 1, 10, 3, 4], [10, 2, 8, 3, 8], [10, 3, 2, 18, 1],\
#     [10, 4, 3, 1, 4], [10, 5, 6, 20, 5], [10, 6, 7, 14, 8], [10, 7, 10, 8, 2], [10, 8, 8, 3, 3], [10, 9, 8, 12, 8], [10, 11, 4, 7, 7], [10, 12, 9, 4, 10], [10, 13, 5, 12, 8], [10, 14, 3, 7, 6], [11, 0, 4, 11, 8], [11, 1, 4, 18, 5],\
#     [11, 2, 4, 2, 3], [11, 3, 2, 20, 8], [11, 4, 5, 5, 5], [11, 5, 7, 16, 5], [11, 6, 10, 18, 1], [11, 7, 2, 5, 1], [11, 8, 8, 17, 1], [11, 9, 9, 10, 8], [11, 10, 6, 12, 5], [11, 12, 9, 12, 3], [11, 13, 7, 5, 1],\
#     [11, 14, 3, 7, 9], [12, 0, 7, 3, 3], [12, 1, 2, 19, 4], [12, 2, 10, 10, 7], [12, 3, 3, 19, 8], [12, 4, 3, 20, 6], [12, 5, 8, 6, 6], [12, 6, 3, 8, 9], [12, 7, 2, 12, 6], [12, 8, 4, 17, 7], [12, 9, 3, 4, 1],\
#     [12, 10, 2, 2, 5], [12, 11, 6, 9, 3], [12, 13, 2, 10, 4], [12, 14, 4, 7, 2], [13, 0, 8, 17, 4], [13, 1, 4, 13, 5], [13, 2, 2, 20, 8], [13, 3, 9, 4, 7], [13, 4, 9, 4, 8], [13, 5, 9, 20, 2], [13, 6, 10, 18, 4],\
#     [13, 7, 2, 2, 10], [13, 8, 6, 18, 4], [13, 9, 3, 18, 9], [13, 10, 6, 19, 7], [13, 11, 5, 7, 9], [13, 12, 6, 3, 3], [13, 14, 10, 12, 8], [14, 0, 2, 4, 2], [14, 1, 10, 3, 9], [14, 2, 5, 19, 4], [14, 3, 2, 8, 2],\
#     [14, 4, 7, 5, 8], [14, 5, 3, 18, 8], [14, 6, 3, 11, 7], [14, 7, 8, 17, 2], [14, 8, 8, 12, 2], [14, 9, 9, 17, 6], [14, 10, 6, 9, 3], [14, 11, 7, 15, 8], [14, 12, 7, 4, 6], [14, 13, 2, 2, 9]],
#     "commodities": [[1, 9, 4, 5], [1, 10, 3, 7], [3, 4, 8, 4], [4, 11, 4, 2], [6, 12, 4, 5], [7, 4, 8, 7], [7, 10, 4, 5], [10, 8, 4, 5], [11, 4, 8, 7], [11, 12, 7, 4], [13, 6, 7, 7], [14, 1, 6, 5]],
# }
# 超大规模
inst = {
    "name": "huge_complete_30_k150",
    "num_nodes": 30,
    "num_arcs": 870,
    "num_commodities": 150,
    "total_demand": 686,
    "arcs": [...]
}

# 构造出工具所需的数据格式
C = [k for k in range(1,1+len(inst['commodities']))]
N = [n for n in range(inst['num_nodes'])]
A = [(node1,node2) for node1,node2,_,_,_ in inst['arcs']]
stnode_dict = {}
l_dict = {}
d_dict = {}
u_dict = {}
adjacency_list_dict = {}
for k in C:
  stnode_dict[k]=(inst['commodities'][k-1][0],inst['commodities'][k-1][1])
  l_dict[k] = inst['commodities'][k-1][3]
  d_dict[k] = inst['commodities'][k-1][2]
  adjacency_list_dict[k] = [[] for _ in range(inst['num_nodes'])]
  for node1,node2,_,cost,weight in inst['arcs']:
    adjacency_list_dict[k][node1].append((node2,cost,weight))
for node1,node2,u,_,_ in inst['arcs']:
  u_dict[(node1,node2)] = u

if __name__ == '__main__':
  import sys
  sys.path.append('../../../')
  from Colossus import ToolBox,Environment,Engine
  from initial_cols import generateInitialCols
  from rmp_model import buildRestrictedMP
  from exact_sp import updateAndSolveSP_Exact
  # 把框架需要的工具搭建好
  toolbox = ToolBox()
  toolbox.addTool('generateInitialCols',generateInitialCols,C,A,stnode_dict,l_dict,adjacency_list_dict)
  toolbox.addTool('buildRestrictedMP',buildRestrictedMP,d_dict=d_dict,A=A,u_dict=u_dict)
  toolbox.addTool('updateAndSolveSP_Exact',updateAndSolveSP_Exact,C=C,A=A,arcs_info=inst['arcs'],stnode_dict=stnode_dict,l_dict=l_dict)
  # 求解环境搭建好
  environment = Environment('h',[],[],fingerprint_lst=C)
  environment.heuristic_solve_on = False
  environment.col_file_output_on = False
  environment.result_file_output_on = True
  # 构造求解引擎
  engine = Engine('MCFPwithSC_engine',environment,toolbox)
  engine.runEngine()
复现效果
对于一般规模的算例基本上不用1秒的时间就可以把精确解搞出来,对于超大规模算例也就只需要几秒钟的时间就可以实现精确求解。
求解日志>>Engine配置信息
[1] Environment(variables_name='h', relaxed_variables_name=[], relaxed_variables_type=[], fingerprint_lst=[1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 16, 17, 18, 19, 20, 21, 22, 23, 24, 25, 26, 27, 28, 29, 30, 31, 32, 33, 34, 35, 36, 37, 38, 39, 40, 41, 42, 43, 44, 45, 46, 47, 48, 49, 50, 51, 52, 53, 54, 55, 56, 57, 58, 59, 60, 61, 62, 63, 64, 65, 66, 67, 68, 69, 70, 71, 72, 73, 74, 75, 76, 77, 78, 79, 80, 81, 82, 83, 84, 85, 86, 87, 88, 89, 90, 91, 92, 93, 94, 95, 96, 97, 98, 99, 100, 101, 102, 103, 104, 105, 106, 107, 108, 109, 110, 111, 112, 113, 114, 115, 116, 117, 118, 119, 120, 121, 122, 123, 124, 125, 126, 127, 128, 129, 130, 131, 132, 133, 134, 135, 136, 137, 138, 139, 140, 141, 142, 143, 144, 145, 146, 147, 148, 149, 150], barrier_method_on=True, exact_solve_on=True, heuristic_solve_on=False, mini_batch_percent=1.0, lp_file_ouput_on=True, ilp_file_output_on=True, col_file_output_on=False, result_file_output_on=True, dual_alpha=0, truncate_threshold=1e-06, max_not_bertter=inf, max_time_limit=3600.0, rmp_log_to_console=False)
[2] ToolBox contains tools: buildRestrictedMP, generateInitialCols, updateAndSolveSP_Exact
>>Note:在调用runEngine前请先检查配置是否满足你的要求

>>预备:初始列构造完毕
Set parameter Username
Set parameter LicenseID to value 2759492
Academic license - for non-commercial use only - expires 2026-12-27
Set parameter LogToConsole to value 0
>>限制主问题数学模型构造完毕,进入列生成迭代轮次

>>列生成迭代过程:
+-----+---------+---------+--------------+----------+------------+------------+------------+
|iter |time(s)  |cols_num |rmp_obj       |no_better |rmp_time(s) |sps_method  |sps_time(s) |
+-----+---------+---------+--------------+----------+------------+------------+------------+
|1    |1.89     |150      |5,706,069.00  |0         |0.00        |exact       |1.89        |
|2    |3.75     |174      |7,115.00      |0         |0.00        |exact       |1.85        |
|3    |5.54     |181      |7,108.00      |0         |0.00        |exact       |1.78        |
+-----+---------+---------+--------------+----------+------------+------------+------------+
>>列生成迭代轮次终止,下面将根据现有ColumnPool对主问题进行求解:

Gurobi Optimizer version 12.0.0 build v12.0.0rc1 (win64 - Windows 11+.0 (26200.2))

CPU model: 11th Gen Intel(R) Core(TM) i5-1135G7 @ 2.40GHz, instruction set [SSE2|AVX|AVX2|AVX512]
Thread count: 4 physical cores, 8 logical processors, using up to 8 threads

Optimize a model with 1020 rows, 331 columns and 688 nonzeros
Coefficient statistics:
  Matrix range     [1e+00, 1e+00]
  Objective range  [1e+00, 1e+05]
  Bounds range     [0e+00, 0e+00]
  RHS range        [1e+00, 4e+01]

Solved in 0 iterations and 0.00 seconds (0.00 work units)
Optimal objective  7.108000000e+03
>>已经将Engine=MCFPwithSC_engine的求解结果写入MCFPwithSC_engine.result文件中
[Finished in 6.7s]
附:求解RCSSP问题的标签算法
| 记号 | 含义 |
|---|---|
| 有向图:节点集 |
|
| 源点(origin)与汇点(destination) | |
| 权重上限(每商品 |
|
| 弧 |
|
| 弧 |
|
| 从节点 |
|
| 优先队列:标签按 cost 升序排列 | |
| 节点 |
|
| 节点 |
输入: 图
输出: 满足
初始化
;
选择标签:若
,终止;否则删除 中第一个(cost 最小)标签 。 处理标签:对每一条出弧
: - (a) 资源剪枝:若
,转到下一条弧; - (b) 被支配剪枝:若存在标签
满足 且 , 则新标签被支配,转到下一条弧; - (c) 生成新标签:否则令
,然后 - 创建新标签
; - 若
(非汇点),把新标签插入 ; - 反向删除:若存在旧标签
满足 且 ,则从 中删除 ; - 更新
,回到步骤 2。
- 创建新标签
- (a) 资源剪枝:若
 微信


